
使用Python实现与Ollama运行的模型对话
作者:冯一川
本文介绍如何通过 Python 调用 Ollama 中运行的千问(qwen2:7b)小模型进行对话,首先回顾 Ollama 的安装与模型拉取,接着演示使用 ollama run 启动模型,最后通过 Python 的 requests 库调用本地 API 接口,实现与大模型的交互问答,需要的朋友可以参考下
摘要: 本文介绍如何通过 Python 调用 Ollama 中运行的千问(qwen2:7b)小模型进行对话。首先回顾 Ollama 的安装与模型拉取,接着演示使用 ollama run 启动模型,最后通过 Python 的 requests 库调用本地 API 接口,实现与大模型的交互问答。
现在使用 Ollama 运行一个小模型,使用 Python 调用这个小模型进行对话。
小模型以千问为例。我的显卡只有 8G,就拉取一个小的 qwen2:7b 模型。
拉取千问模型
查看 Ollama 版本
ollama --version
拉取模型:
ollama pull qwen2:7b
拉取过程中会显示进度条,等进度条走完(第一次下载 4GB 左右)。
运行千问:
ollama run qwen2:7b
运行成功后即可开始对话。
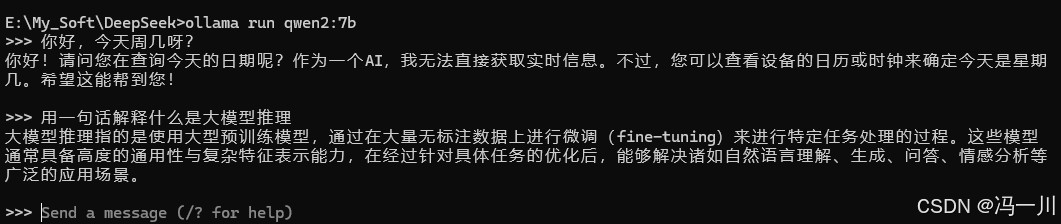
退出按 Ctrl+D,或者输入 /bye。
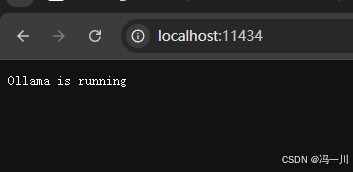
先确认 Ollama 的 API 服务正在运行。
Ollama 安装后默认会常驻后台,打开浏览器访问:
http://localhost:11434
Python调用模型
创建一个 Python 脚本
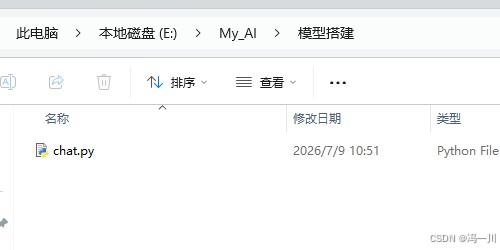
编写内容:
import requests
import json

def ask_model(prompt, model="qwen2:7b"):
    url = "http://localhost:11434/api/generate"

    payload = {
        "model": model,
        "prompt": prompt,
        "stream": False  # 一次性返回完整结果
    }

    response = requests.post(url, json=payload)
    data = response.json()
    return data["response"]

# 测试
if __name__ == "__main__":
    question = "用一句话解释什么是大模型推理"
    answer = ask_model(question)
    print(f"Q: {question}")
    print(f"A: {answer}")
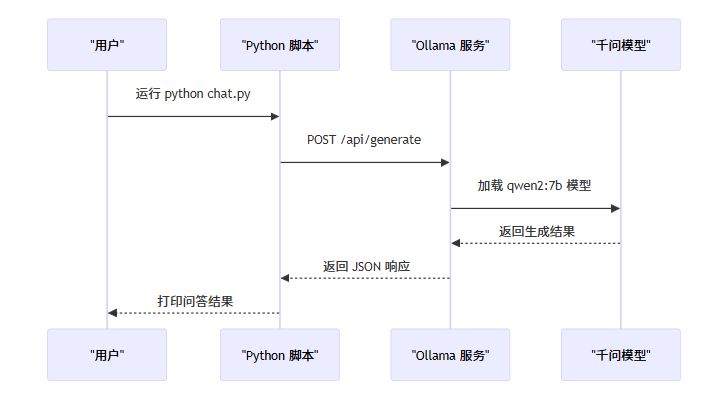
下面是 Python 调用 Ollama 模型的完整流程:
运行 Python 脚本
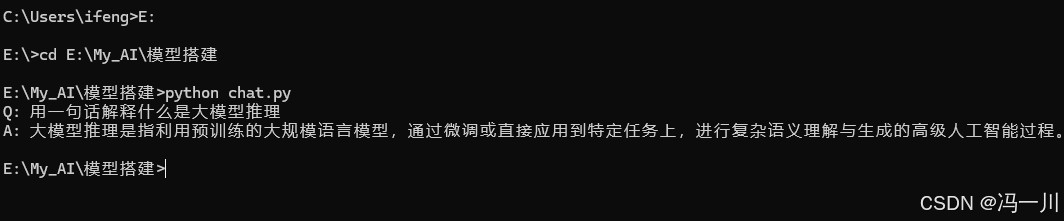
然后我们运行这个脚本:
python chat.py
结果如下:
到此这篇关于使用Python实现与Ollama运行的模型对话的文章就介绍到这了,更多相关Python Ollama运行的模型对话内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!