Python itertools 盘点真正用得上的20个常用方法
作者:卷无止境
Python 标准库里藏着一个被严重低估的宝藏模块——itertools。几乎每个 Python 开发者都 import 过它,但大多数人只用其中三四个函数,剩下的就像工具箱里生锈的扳手,从来没碰过。这篇报告把全部 20 个函数梳理清楚,按照"你在真实代码里会多频繁用到它"来排序,而不是照着官方文档的顺序念经。
一、什么是itertools,为什么值得认真学?
itertools 是 Python 标准库中专门处理迭代器的模块,灵感来自 APL、Haskell 和 SML 等函数式编程语言。它的核心哲学是构建一套"迭代器代数"——把简单的迭代器组合起来,搭出复杂而高效的数据处理流水线。
两个关键优势让它与众不同:
- 内存效率极高:
itertools的函数几乎全部是惰性求值(lazy evaluation)的,也就是说数据不会一次性全部加载进内存,而是用到哪块算哪块。处理一个几十 GB 的日志文件,和处理一个 10 行的列表,内存占用几乎没有区别。 - 速度快:底层用 C 实现,比手写的 Python 循环快得多。研究表明,
itertools在节省内存的同时,速度损耗微乎其微,对绝大多数真实场景来说是非常划算的交换。
理解 itertools 之前,先要搞清楚两个概念:
- 可迭代对象(Iterable) :能被
for循环遍历的东西,比如列表、字符串、字典。 - 迭代器(Iterator) :一种特殊的可迭代对象,只能向前走,不能回头,调用
next()一次吐出一个元素。itertools的所有函数返回的都是迭代器。
二、函数全景图
官方文档把 20 个函数分成三大类,下面这张表是最清晰的全貌:
| 类别 | 函数 | 一句话描述 |
|---|---|---|
| 通用迭代器 | chain, chain.from_iterable | 拼接多个可迭代对象 |
| 通用迭代器 | islice | 切片迭代器 |
| 通用迭代器 | compress | 按布尔掩码过滤 |
| 通用迭代器 | filterfalse | 过滤掉满足条件的元素 |
| 通用迭代器 | starmap | 解包参数后调用函数 |
| 通用迭代器 | pairwise | 相邻两两配对(3.10+) |
| 通用迭代器 | batched | 按批次分组(3.12+) |
| 通用迭代器 | groupby | 按键分组(需预排序) |
| 通用迭代器 | accumulate | 累积计算(如累加) |
| 通用迭代器 | takewhile / dropwhile | 按条件截取/跳过 |
| 通用迭代器 | tee | 复制迭代器 |
| 通用迭代器 | zip_longest | 补齐长度的 zip |
| 无限迭代器 | count, cycle, repeat | 无限计数/循环/重复 |
| 组合迭代器 | combinations, permutations, product, combinations_with_replacement | 排列组合笛卡尔积 |
三、最常用的函数:日常代码的主力军
chain()和chain.from_iterable()— 拼接利器
chain() 是使用频率最高的函数之一,把多个可迭代对象首尾相连,变成一个统一的迭代器,不需要真正合并成一个新列表。
from itertools import chain

# 把三个列表拼成一个流,不占额外内存
result = list(chain([1, 2], [3, 4], [5, 6]))
# → [1, 2, 3, 4, 5, 6]
chain.from_iterable() 是它的变体,专门处理"列表的列表"这种嵌套结构,效果等同于 chain(*nested),但不需要把整个嵌套列表先解包:
nested = [[1, 2], [3, 4], [5, 6]]
result = list(chain.from_iterable(nested))
# → [1, 2, 3, 4, 5, 6]
实际场景:爬虫抓回来多页数据存在多个列表里,用 chain 一行搞定合并,比 sum(lists, []) 快得多。
islice()— 迭代器的切片刀
普通列表可以用 [start:stop:step] 切片,但迭代器不行。islice() 就是专门为迭代器设计的切片工具,有一个重要限制:不支持负数索引。
from itertools import islice

# 从无限计数器里取前5个
from itertools import count
first_five = list(islice(count(10), 5))
# → [10, 11, 12, 13, 14]

# 跳过前3行,读取第4到第10行
with open("bigfile.txt") as f:
    lines = list(islice(f, 3, 10))
处理大文件时,这个函数特别好用——不用把整个文件读进内存,按需取用。
groupby()— 分组神器,但有个大坑
groupby() 按照某个键把连续相同的元素分成组,非常适合做数据聚合。但这里有个经典陷阱:它只对连续相同的元素分组,所以使用前必须先按同一个键排好序,否则结果会出乎意料。
from itertools import groupby

data = [
    {"name": "Alice", "dept": "Engineering"},
    {"name": "Bob",   "dept": "Engineering"},
    {"name": "Carol", "dept": "Marketing"},
]
# 必须先排序!
data.sort(key=lambda x: x["dept"])

for dept, members in groupby(data, key=lambda x: x["dept"]):
    print(dept, list(members))
这个行为和 Unix 的 uniq 命令一模一样——只合并相邻的重复项。
accumulate()— 不只是求和
大多数人只知道 accumulate 能算累加,但它接受任意二元函数,可以做累积乘积、滚动最大值等各种操作:
from itertools import accumulate
import operator

nums = [1, 2, 3, 4, 5]

# 累加:1 3 6 10 15
print(list(accumulate(nums)))

# 累积乘积:1 2 6 24 120
print(list(accumulate(nums, operator.mul)))

# 滚动最大值:1 2 3 4 5
print(list(accumulate(nums, max)))

# 带初始值
print(list(accumulate(nums, initial=100)))
# → [100, 101, 103, 106, 110, 115]
金融数据分析、游戏得分累计、滑动窗口统计,这个函数都能派上用场。
pairwise()和batched()— 两个"为什么我以前要手写这个"的函数
Reddit 上那篇帖子特别点名了这两个函数,因为太多人在不知道它们的情况下,自己写了一堆笨拙的代码来实现同样的功能。
pairwise()(Python 3.10+)生成相邻元素的两两配对:
from itertools import pairwise

steps = list(pairwise([1, 2, 3, 4, 5]))
# → [(1,2), (2,3), (3,4), (4,5)]

# 计算相邻差值,比如股价涨跌
prices = [100, 105, 98, 110]
changes = [b - a for a, b in pairwise(prices)]
# → [5, -7, 12]
batched()(Python 3.12+)把一个迭代器切成固定大小的批次,最后一批可以比指定大小短:
from itertools import batched

data = range(10)
for batch in batched(data, 3):
    print(batch)
# → (0,1,2)  (3,4,5)  (6,7,8)  (9,)
批量调用 API、分页写数据库,batched 直接替代手写的 [data[i:i+n] for i in range(0, len(data), n)]。
四、进阶函数:用得少但关键时刻救命
starmap()— 优雅地解包参数
当你有一个"参数元组的列表",想对每个元组调用同一个函数时,starmap() 比 map() 更优雅:
from itertools import starmap

pairs = [(2, 5), (3, 2), (10, 3)]
result = list(starmap(pow, pairs))
# → [32, 9, 1000]

# 等价于但比下面这个更简洁:
# [pow(a, b) for a, b in pairs]
tee()— 复制迭代器,但要小心
tee(it, n) 把一个迭代器复制成 n 个独立的迭代器,每个都能独立遍历。听起来很美,但有个内存陷阱:它会在内部缓存所有已经被某个副本消费但其他副本还没读到的元素。如果两个副本的进度差很大,内存消耗会很可观。
from itertools import tee

a, b = tee([1, 2, 3, 4, 5])
# a 和 b 是独立的,互不影响
print(list(a))  # → [1, 2, 3, 4, 5]
print(list(b))  # → [1, 2, 3, 4, 5]
原则:tee 之后,原始迭代器就不要再用了。
zip_longest()— 不丢数据的 zip
内置 zip() 以最短的序列为准,多余的元素直接丢掉。zip_longest() 则以最长的为准,短的用 fillvalue 补齐:
from itertools import zip_longest

a = [1, 2, 3, 4]
b = ['x', 'y']
result = list(zip_longest(a, b, fillvalue='-'))
# → [(1,'x'), (2,'y'), (3,'-'), (4,'-')]
takewhile()和dropwhile()— 条件截断
这两个函数是一对反义词,都接受一个判断函数和一个序列:
from itertools import takewhile, dropwhile

data = [1, 4, 6, 3, 8]

# 只要条件为真就继续取,一旦为假立刻停止(后面的不再检查)
list(takewhile(lambda x: x < 5, data))  # → [1, 4]

# 跳过条件为真的,从第一个为假的开始取所有剩余元素
list(dropwhile(lambda x: x < 5, data))  # → [6, 3, 8]
注意 dropwhile 的行为:它跳过开头满足条件的元素,但一旦开始输出,后面的元素不再检查条件,全部输出。
五、无限迭代器:小心别让程序跑死
这三个函数会产生无穷无尽的元素,必须配合 islice()、takewhile() 或 zip() 来截断,否则程序会永远跑下去。
from itertools import count, cycle, repeat

# count:从10开始,步长2,无限递增
# 10, 12, 14, 16, ...
for n in count(10, 2):
    if n > 20: break

# cycle:无限循环一个序列
# 'A', 'B', 'C', 'A', 'B', 'C', ...
# 注意:cycle 会把整个序列复制一份存在内存里

# repeat:重复一个对象 n 次(省略 n 则无限)
list(repeat(7, 3))  # → [7, 7, 7]
count 和 zip() 配合是个经典技巧,可以替代 enumerate(),而且步长更灵活。
六、组合迭代器:排列组合的数学世界
这四个函数处理排列组合问题,在密码学、测试用例生成、数学枚举场景里很常见。
from itertools import combinations, permutations, product, combinations_with_replacement

items = ['A', 'B', 'C']

# 组合:顺序无关,不重复,C(3,2)=3种
list(combinations(items, 2))
# → [('A','B'), ('A','C'), ('B','C')]

# 排列:顺序有关,不重复,P(3,2)=6种
list(permutations(items, 2))
# → [('A','B'), ('A','C'), ('B','A'), ('B','C'), ('C','A'), ('C','B')]

# 笛卡尔积:等价于嵌套 for 循环
list(product([0,1], repeat=3))
# → 所有3位二进制数,共8种

# 有放回组合:允许重复元素
list(combinations_with_replacement('AB', 2))
# → [('A','A'), ('A','B'), ('B','B')]
数学上,这四者的关系可以用公式表示。对于从 n 个元素中取 r 个:
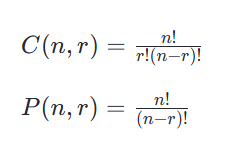
笛卡尔积的总数则是各序列长度的乘积。
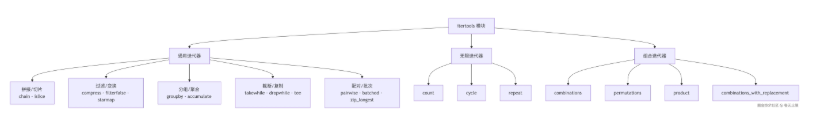
七、函数关系速查图
用一张流程图展示这 20 个函数的分类关系:
八、实战:组合使用才是真正的威力
itertools 的真正魔力在于组合。单个函数只是积木,拼在一起才能搭出漂亮的东西。
场景:处理分页 API 数据,跳过前两页,取接下来三页的所有结果
from itertools import chain, islice

# 假设 fetch_page(n) 返回第 n 页的数据列表
pages = (fetch_page(n) for n in range(10))

# 跳过前2页,取接下来3页,展平成一个流
result = list(chain.from_iterable(islice(pages, 2, 5)))
场景:给数据流打上行号,但从 1001 开始
from itertools import count

data = ["apple", "banana", "cherry"]
numbered = list(zip(count(1001), data))
# → [(1001, 'apple'), (1002, 'banana'), (1003, 'cherry')]
场景:找出列表中所有连续递增的片段
from itertools import groupby
from itertools import pairwise

nums = [1, 2, 3, 1, 2, 4, 5]
# 用 pairwise 计算差值,再用 groupby 找连续的 +1 段
diffs = [b - a for a, b in pairwise(nums)]
# → [1, 1, -2, 1, 2, 1]
九、使用时的几个注意事项
学到这里,有几个容易踩的坑值得单独说清楚:
迭代器只能走一遍:itertools 返回的都是迭代器,遍历一次就"耗尽"了。如果需要多次遍历,要么转成 list(),要么用 tee()。
groupby 必须预排序:这是最常见的 bug 来源。groupby 只合并相邻的相同元素,不会自动排序。
无限迭代器要有出口:count()、cycle() 没有终点,一定要配合截断函数使用。
cycle() 会复制数据:cycle 内部会把整个序列存一份,处理超大序列时要注意内存。
islice 不支持负索引:想取最后 N 个元素,用 collections.deque(it, maxlen=N) 更合适。
结语
itertools 就像一套精心设计的乐高积木——每一块单独看都简单,但组合起来能搭出令人惊叹的结构。从最常用的 chain、islice、groupby,到很多人从未用过的 pairwise、batched、starmap,这 20 个函数覆盖了数据处理中绝大多数"需要循环但又不想写一堆循环"的场景。
真正掌握 itertools 的标志,不是能背出每个函数的参数,而是在写代码时脑子里自然而然地想到"这里可以用 accumulate"或者"这里用 chain.from_iterable 比列表推导式更优雅"。那种感觉,值得花时间练习。
到此这篇关于Python itertools 盘点真正用得上的20个常用方法的文章就介绍到这了,更多相关Python itertools常用方法内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!