
如何解决HikariCP获取连接超时?连接池占用与泄漏问题处理
作者:代码漫游者yu
前一分钟接口还正常,后一分钟就集体超时。日志里反复出现同一句话:
Connection is not available, request timed out after 30000ms
1. 连接池不是一个无限开关
应用每次访问数据库,都要先从连接池拿一个连接。拿到连接后,应用执行 SQL,再把连接归还。如果归还之前发生了问题,连接就会一直占用下去。
HikariCP 默认的 connectionTimeout 是 30 秒,最低允许 250 毫秒。超过等待时间后,请求会抛异常。所以“接口突然全部超时”通常是这样一个过程:
- 某些请求拿到连接后长时间没有归还;
- 池子里所有连接都被占满;
- 后续请求进入等待;
- 30 秒一到,等待的请求全部失败。
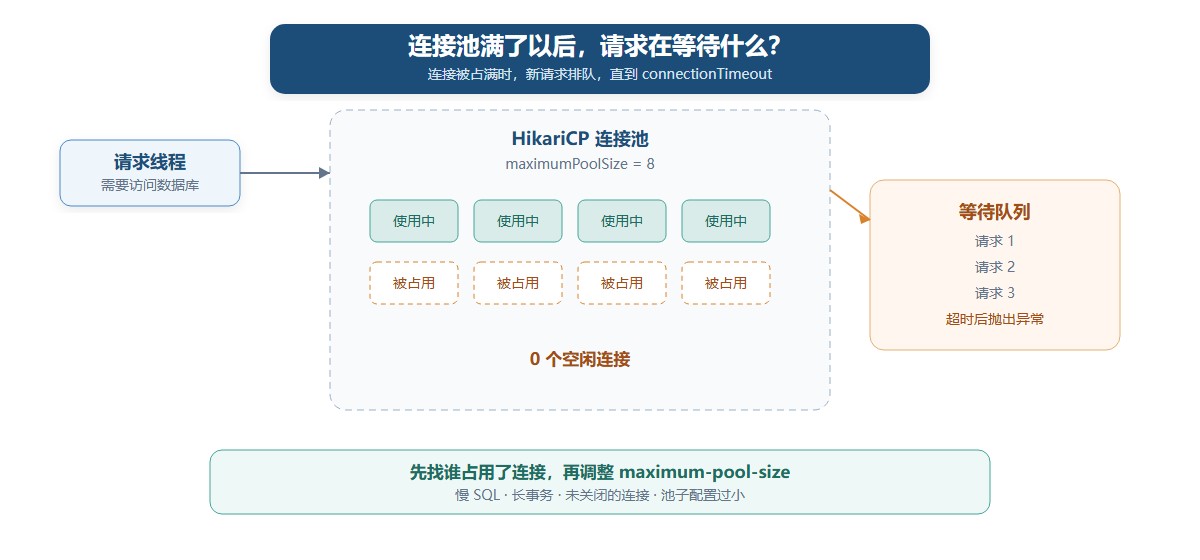
图 1:池子大小有限,占用不归还会让后面的请求排队到超时。
这里有一个容易误判的点:日志里报的是“获取连接超时”,但真正的病根往往不在连接池本身,而在“谁占用了连接、为什么这么久”。
2. 慢 SQL 和长事务,是最常见的占用者
连接只有在被归还后,才能给下一个请求使用。如果某个接口执行一条 10 秒的 SQL,或者在事务里调用外部服务、发消息、循环查询,连接就会被长期占用。
一个事务方法可能看起来很短:
@Transactional
public void createOrder(Order order) {
    orderMapper.insert(order);
    notificationClient.send(order);
    stockMapper.deduct(order);
}
在 notificationClient.send 期间,数据库连接仍然被事务持有。如果这个外部调用耗时 3 秒,每个请求就会比预期多占用 3 秒连接。并发一上来,池子很容易被打满。
所以排查连接池耗尽时,第一步不是改池子配置,而是找到执行时间最长的 SQL 和事务边界。很多“连接不够”的本质,是 SQL 太慢或事务把不该包含的操作包了进来。
3. 连接泄漏:拿到连接却不归还
连接泄漏和慢 SQL 不同。慢 SQL 最终会归还连接,泄漏则永远不会归还。
Connection conn = dataSource.getConnection();
conn.createStatement().executeQuery("SELECT 1");
// 没有 conn.close()
上面的代码每次执行都会少一个可用连接。随着时间推移,idle 连接归零,active 连接持续等于最大值,接口开始排队超时。
正确写法是交给 try-with-resources:
try (Connection conn = dataSource.getConnection();
     PreparedStatement stmt = conn.prepareStatement("SELECT 1")) {
    stmt.executeQuery();
}
Connection、Statement、ResultSet 都实现了 AutoCloseable,方法结束时会被自动关闭。
只有在确实需要跨越方法边界的连接时,才手动管理生命周期,并且必须在 finally 或等价结构中归还。
4.leak-detection-threshold能帮你找到泄漏点
Spring Boot 中可以这样配置 HikariCP:
spring:
  datasource:
    hikari:
      maximum-pool-size: 20
      minimum-idle: 5
      connection-timeout: 3000
      leak-detection-threshold: 10000
max-lifetime: 1800000leak-detection-threshold控制连接借出超过多久后打印“可能泄漏”的日志。这个日志通常包含连接借出时的堆栈,能告诉你是在哪个代码位置拿走了连接。它不会解决问题,但能把“池子满了”变成“具体哪个方法占了连接”。max-lifetime建议比数据库或网络设备主动断开的超时时间短几秒,避免连接已经被服务端断开、客户端还以为它可用。connection-timeout建议小于接口自身的超时时间。连接获取失败应该尽快失败,而不是让请求一直卡在池子外面。
5. 用指标确认是“池子满”,还是“数据库满”
发生异常时,先看 HikariCP 暴露的指标:
active connections
idle connections
pending threads
connection timeout
connection creation
connection acquire time
如果使用 Spring Boot Actuator 和 Micrometer,可以看到类似 hikaricp.connections.active、hikaricp.connections.idle、hikaricp.connections.pending 的指标。
关键判断是:
active长时间等于maximumPoolSize,说明连接都被借出;pending持续大于 0,说明已经有请求在排队;idle长期为 0,说明池子没有余量;- 获取连接的平均耗时升高,通常意味着等待开始出现。
还有一种情况要区分:如果池子能创建新连接,但数据库报 too many connections,说明数据库侧连接上限先被打满。
这时的问题不在 HikariCP 的参数,而在数据库的 max_connections 和整个集群的总连接预算。
6. 池子不是越大越好
连接池大小没有万能答案。早期 HikariCP 的文档给出过一个经验公式:
connections = (core_count * 2) + effective_spindle_count
它考虑了 CPU 核心和磁盘能力,但只适合作为起点,不适合照抄到所有环境。现代数据库、云实例、读写分离和容器化部署都会影响结果。
更大的池子意味着更多连接、更多数据库端资源占用和更大的管理开销。
如果数据库连接上限只有 100,应用却把池子配到 200,数据库会先扛不住。
池子大小应该和数据库的 max_connections、实例规格、事务时长和实际并发一起评估,再通过压测确认。
7. 修复时不要只会调大数字
连接池耗尽通常只是表象,真正要处理的是“谁占用了连接、为什么这么久”。
可以先做这几件事:
- 找慢 SQL,加索引、拆分大查询、减少不必要的字段;
- 缩短事务范围,不要在执行 SQL 期间调用远程接口或发送消息;
- 确认所有连接、语句和结果集都在 try-with-resources 中关闭;
- 根据数据库连接上限和压测结果设置合理的
maximum-pool-size; - 观察
leak-detection-threshold打印的堆栈,找到泄漏点; - 用缓存、读写分离或异步任务减少数据库连接占用。
如果只是把 maximum-pool-size 从 20 改到 200,池子可能不再报超时,但数据库会被新进来的并发请求压垮,问题只是换了个位置出现。
总结
HikariCP 连接池耗尽,说明连接被借出后没有及时归还。
它可能是慢 SQL、长事务、连接泄漏或池子配置不合理。修复顺序应该是先找到占用者,再调整池子大小,而不是先把数字调大。
以上为个人经验,希望能给大家一个参考,也希望大家多多支持脚本之家。