Go 编译器SSA 优化tighten pass的详细过程
作者:互联网中的一颗神经元
Go 编译器 SSA 优化tightenpass 过程
tighten 是 Go 编译器 SSA 优化阶段的一个 代码移动(code motion) pass,核心目的是把值的定义尽量移动到离使用点更近的基本块,从而缩短值的活跃区间、降低寄存器压力、减少 spill/reload。
第一部分:前置知识 —— 什么是 SSA
1.1 从"变量"到"值":SSA 的核心思想
SSA = Static Single Assignment(静态单一赋值)。
普通编程语言里,变量可以被反复赋值:
x = 1
x = x + 1
x = x * 2
同一个名字 x 出现了三次,代表三个不同的值。编译器很难分析"某一处用到的 x 到底是哪一个"。
SSA 强制一条纪律:每个名字(每个"值")只能被赋值一次。上面的代码在 SSA 里变成:
v1 = 1
v2 = v1 + 1
v3 = v2 * 2
每个 v# 是一个值节点(Value),一旦产生就不再改变。
这样做能使"值"和"变量的某个时刻"一一对应,编译器能直接看出:
v2依赖v1(v2的输入是v1)v1被v2使用(v1的使用者是v2)
于是整个程序就成了一张依赖图(有向无环图 DAG),而不是一串模糊的赋值语句。所有优化 pass(包括 tighten)都是在这张图上做变换。
1.2 SSA 的三层结构
Go 的 SSA 有三个层级:
| 层级 | 结构 | 类比 |
|---|---|---|
| Function(函数) | *Func | 一个完整的函数 |
| Block(基本块) | *Block | 一段顺序执行、只有一个入口一个出口的代码 |
| Value(值 / 指令) | *Value | 一条指令,或它算出来的那个值 |
一个函数包含若干基本块,每个基本块包含若干值。
1.3 Value 结构详解
type Value struct {
    ID     ID           // 全函数唯一编号
    Op     Op           // 操作类型(Add64 / Load / Store / Phi ...)
    Type   *types.Type  // 结果的类型
    AuxInt int64        // 附加的整数信息(如常量值)
    Aux    Aux          // 附加的其他信息(如符号名)
    Args   []*Value     // 操作数(输入),全是别的 Value 的指针
    Block  *Block       // 属于哪个基本块
    Pos    src.XPos     // 源码位置(文件:行:列)
    Uses   int32        // 被引用的次数
    ...
}
用一段真实代码感受一下
func Sum(a, b int) int {
    x := a + b   // 第2行
    y := x * 2   // 第3行
    return y     // 第4行
}
它生成的 SSA(机器无关阶段,示意):
b1:                                    ← 基本块 1
    v1 = InitMem               <mem>          ← 内存链起点(编译器自动插入)
    v2 = SP                    <uintptr>      ← 栈指针(自动插入)
    v3 = SB                    <uintptr>      ← 全局基址(自动插入)
    v4 = Arg    <int> {a}                     ← 参数 a
    v5 = Arg    <int> {b}                     ← 参数 b
    v6 = Add64  <int>  v4 v5                  ← x = a + b
    v7 = Const64 <int>  [2]                   ← 字面量 2
    v8 = Mul64  <int>  v6 v7                  ← y = x * 2
    v9 = Return <int>  v8                     ← return y
逐行对应:
| 源码 | 生成的 Value | Op | Type | Args | 说明 |
|---|---|---|---|---|---|
形参 a | v4 | Arg | <int> | 无 | Aux 记录参数名 |
形参 b | v5 | Arg | <int> | 无 | |
a + b | v6 | Add64 | <int> | v4, v5 | 两个输入 |
2 | v7 | Const64 | <int> | 无 | AuxInt = 2 |
x * 2 | v8 | Mul64 | <int> | v6, v7 | |
return y | v9 | Return | <int> | v8 |
Value 的Type是"输出类型"
这一点极其重要,也是最容易混淆的地方:
//           ↓ 结果类型
v9 = Store <mem> p, val, mem
//               ↑   ↑    ↑ 这是 3 个输入,不是 v9 的类型
v9.Type == Mem→v9这个内存令牌结果不占寄存器;- 但输入
p(指针)和val(要写的值)是另外的 Value,它们类型是*int/int,各自都需要寄存器。
needRegister 之类的判断只看 v.Type(输出),不看输入;输入要不要寄存器,由那个输入自己的 Value 决定。
1.4 基本块与控制流图(CFG)
基本块(Basic Block) = 一段"从头进、顺序走、从尾出"的代码。中间没有跳转进来,也没有跳转出去。
块与块之间用有向边连接,构成控制流图(Control Flow Graph, CFG)。
例子
func f(a, b int) int {
    if a > b {      // 分支
        return a
    }
    return b
}
CFG:
        b1 (entry)
        |  a > b ?
       / \
      /   \
   真/     \假
    /       \
  b2        b3
 return a   return b
块的三要素
一个基本块,本质上由三样东西完全确定:
| # | 要素 | 字段 | 回答的问题 | 类比 |
|---|---|---|---|---|
| ① | 块体 | Values | 这个块做了什么事 | 房间里的家具 |
| ② | 入边 | Preds | 能从哪儿进这个块 | 房间的几扇门 |
| ③ | 出边 | Succs | 做完之后往哪儿走 | 房间的出口指示牌 |
type Block struct {
    Kind     BlockKind   // 块的"出口形状"
    Values   []*Value    // 块体:块内定义的值
    Controls [2]*Value   // 出口要用的控制值(如 If 的条件)
    Succs    []Edge      // 出边
    Preds    []Edge      // 入边
    Aux/AuxInt ...       // 出口的附属信息(如跳转目标)
}
块的种类(Go SSA 里叫 BlockKind):
| 种类 | 含义 | 后继数 |
|---|---|---|
BlockPlain | 顺序跳转 | 1 |
BlockIf | 条件分支 | 2 |
BlockRet | 函数返回 | 0 |
BlockExit | 退出 | 0 |
| … |
1.5 支配关系(Dominance)
这是理解 tighten 最关键的概念。
定义
如果从函数入口到块 B 的每一条路径都必须经过块 A,就说 A 支配 B(A dominates B)。
记为 A dom B。
例子
        b1
       /  \
      b2   b3
       \   /
        b4
b1支配所有块(入口必然支配一切);b2不支配b4,因为存在路径b1 → b3 → b4绕过 b2;b4的直接支配者(idom,最近的那个支配者)是b1。
支配树(Dominator Tree)
把所有块的支配关系组织成一棵树:父节点是子节点的 idom。
      b1            ← 根(入口)
     / | \
   b2  b3 b4        ← b4 的 idom 是 b1(不是 b2/b3)
f.Idom() 返回 []*Block,idom[b.ID] = b 的父节点。
1.6 Phi 节点:分支汇合处的值选择
考虑:
func f(cond bool) int {
    var x int
    if cond {
        x = 1
    } else {
        x = 2
    }
    return x + 10
}
x 在两个分支里被赋了不同的值。SSA 不允许"同一个 x 赋值两次",怎么办?
用 Phi(φ)节点:在汇合处创建一个特殊值,它按"来的那条边"选择:
b1: If cond → b2, b3
b2: v1 = Const64 [1]; goto b4
b3: v2 = Const64 [2]; goto b4
b4: v3 = Phi <int> v1, v2      ← 从 b2 来取 v1,从 b3 来取 v2
    v4 = Add64 v3, (Const64 10)
    Return v4
Phi 的核心特征:参数与前驱边一一对应
Phi a, b, c 的第 i 个参数来自第 i 条前驱边:
v.Args[i] ↔ b.Preds[i]
1.7 四类"伪类型"与 needRegister
SSA 里绝大多数值都是"真实数据"(整数、指针、浮点数……),必须住在寄存器里。但有四类例外:
// regalloc.go:742
func (v *Value) needRegister() bool {
    return !v.Type.IsMemory() && !v.Type.IsVoid() && !v.Type.IsFlags() && !v.Type.IsTuple()
}
逐个实例化:
| 伪类型 | 判定 | 实例 | 为什么不占寄存器 |
|---|---|---|---|
| Memory | t == TypeMem | v9 = Store <mem> p, val, mem | 内存版本令牌,靠边流动,不是数据 |
| Void | t == TypeVoid | v8 = LoweredNilCheck <void> v6 v1(schedule 之后) | 什么都没有,只为副作用存在 |
| Flags | t == TypeFlags | v3 = CMPQ <flags> x, y | 条件码住专用 flag 寄存器(EFLAGS/NZCV),与通用寄存器是不同类别 |
| Tuple | kind == TTUPLE | v = AtomicAdd64 <(UInt64,Mem)> | 二元组从不实体化,立刻被 Select0/Select1 拆开,分量各自拿寄存器 |
为什么"只有这四类"不占寄存器
因为 SSA 类型系统里,非真实数据的类型恰好就这四种。其余全是货真价实的 Go 值:
| 真实类型 | 落点 |
|---|---|
整数族(TINT*等) | 通用寄存器 |
| 指针 / 字符串 / 切片头 | 通用寄存器 |
浮点(TFLOAT*) | 浮点寄存器 |
| 布尔 | 通用寄存器 |
| 结构体 / 接口 / map / chan | 多寄存器或内存传递 |
| SIMD 向量 | 向量寄存器 |
补充:什么是 TTUPLE
TTUPLE 是 SSA 后端的内部表示,专门处理"一条指令要返回两个东西"。
// types/type.go:380
type Tuple struct {
    first  *Type
    second *Type
    // Any tuple with a memory type must put that memory type second.
}
四类产生 TTUPLE 的代码:
| 类别 | 形态 | 触发的 Go 代码 | 例子 |
|---|---|---|---|
| 原子/内存操作 | (值, Mem) | atomic.Add/Load/CAS | AtomicAdd64 typ:"(UInt64,Mem)" |
| 带标志位运算 | (值, Flags) | 算术后又比较/分支 | CMPQ 系列、Add64flags |
| 双值运算 | (值, 值) | bits.Mul64/Div64、SIMD 对加载 | OpMul64uhilo → (UInt64,UInt64) |
| 配对加载 | (lo, hi) | 32 位平台原子加载 64 位 | pair.go 的 pairable loads |
元组产生后必须立刻被拆开:
v  = AtomicAdd64 <(UInt64,Mem)> &x, 1, mem
s0 = Select0 <UInt64> v      ← 取 first(和)
s1 = Select1 <Mem>    v      ← 取 second(新内存)
第二部分:为什么需要 tighten
2.1 问题的起源:值定义得太"早"
看这段代码:
func f(c1, c2 bool, p *int) int {
    t := *p + 1        // ← t 在这里就算好了(入口块)
    var r int
    if c1 {            // 第一层菱形
        r = 100
    } else {
        r = 200
    }
    if c2 {            // 第二层菱形
        return t + r   // ← t 直到这里才被用到
    }
    return t * 2       // ← 或者这里
}
控制流:
      b1 (entry)  t = *p + 1 定义在这里
     /  \
    b2   b3            第一层菱形(与 t 无关)
     \   /
      b4
     /  \
    b5   b6            ★ t 在这里才被使用
     \   /
      b7
问题来了:t 在 b1 就算出来了,却要到 b5/b6 才用。中间经过 b2/b3/b4 一大段代码,t 的值必须一直待在寄存器里(或者被溢出到栈上),干等着。
2.2 寄存器压力与 spill
CPU 的通用寄存器数量有限(amd64 约 14 个通用寄存器可用)。当同时"活着"的值超过寄存器数量时,编译器必须把一部分值溢出(spill)到栈上,用的时候再**加载(reload)**回来。
spill/reload 很贵:
| 操作 | 代价 |
|---|---|
| 寄存器访问 | ~0 周期 |
| 栈上 load/store | 几个周期,还可能 cache miss |
t 从 b1 活到 b5/b6,横跨整个函数前段 → 长时间占着一个寄存器 → 加剧争抢 → 别的更容易被 spill。
2.3 tighten 的核心思想
源码注释(tighten.go:9-13)写得极其精炼:
// tighten moves Values closer to the Blocks in which they are used.
// This can reduce the amount of register spilling required,
// if it doesn't also create more live values.
// A Value can be moved to any block that
// dominates all blocks in which it is used.
翻译成人话:
把一个值下沉(sink)到"支配所有使用点的最深块"—— 也就是离使用点最近、且仍然合法的那个公共块。
优化前后对比
优化前:t 在 b1 计算,从 b1 一路活到 b5/b6。
b1:  t = *p + 1
     |
    b2/b3/b4  ← t 一直占着寄存器干等(还要跟这些块里的值抢寄存器!)
     |
    b5/b6:  use t
优化后:t 下沉到 b4(支配 b5 和 b6 的最深块)。
b1:  (t 搬走了,寄存器释放)
     |
    b2/b3/b4:  t = *p + 1     ← 在这里才算,算完马上用
     |
    b5/b6:  use t
收益:t 的活区间从"横跨整个函数前段"缩短到"紧贴使用点" → 寄存器早早释放 → 减少 spill。
第三部分:tighten 完整流程
3.0 总览
tighten 的完整代码在 tighten.go:14-176,可以拆成六个阶段:
┌─────────────────────────────────────────────────────────┐
│ 阶段 0:前置检查                                          │
│   -N 模式(关闭优化)且函数不巨大 → 直接返回               │
├─────────────────────────────────────────────────────────┤
│ 阶段 1:筛选可搬移的值 → canMove[]                        │
│   逐条"钉死清单"过滤 + narg 寄存器压力闸门               │
├─────────────────────────────────────────────────────────┤
│ 阶段 2:准备工具                                          │
│   memState(内存状态) / makeLCArange(LCA 表)              │
│   idom(支配树) / loopnest(循环信息)                      │
├─────────────────────────────────────────────────────────┤
│ 阶段 3:计算目标位置 → target[]          ← 不动点循环内    │
│   扫 Args(含 Phi 前驱特例)+ 扫 ControlValues,滚动求 LCA  │
├─────────────────────────────────────────────────────────┤
│ 阶段 4:循环保护                          ← 不动点循环内  │
│   target 掉进更深循环 → 沿 idom[header] 往外拽            │
├─────────────────────────────────────────────────────────┤
│ 阶段 5:执行搬移                          ← 不动点循环内  │
│   内存一致性检查 → append 到目标块 → swap-remove 原位置   │
│   有搬动则 changed=true,回到阶段 3 重来                   │
└─────────────────────────────────────────────────────────┘
注意阶段 3~5 包在一个 for changed 不动点循环里 —— 搬移会改变其它值的"使用点",触发连锁反应,必须迭代到稳定。
3.2 阶段 1:筛选"可以搬"的值(canMove)
// tighten.go:34-72
for _, b := range f.Blocks {
    for _, v := range b.Values {
        if v.Op.isLoweredGetClosurePtr() {
                // Must stay in the entry block.
                continue
            }
            switch v.Op {
            case OpPhi, OpArg, OpArgIntReg, OpArgFloatReg, OpSelect0, OpSelect1, OpSelectN:
                // Phis need to stay in their block.
                // Arg must stay in the entry block.
                // Tuple selectors must stay with the tuple generator.
                // SelectN is typically, ultimately, a register.
                continue
            }
            // Count arguments which will need a register.
            narg := 0
            for _, a := range v.Args {
                // SP and SB are special registers and have no effect on
                // the allocation of general-purpose registers.
                if a.needRegister() && a.Op != OpSB && a.Op != OpSP {
                    narg++
                }
            }
            if narg >= 2 && !v.Type.IsFlags() {
                // Don't move values with more than one input, as that may
                // increase register pressure.
                // We make an exception for flags, as we want flag generators
                // moved next to uses (because we only have 1 flag register).
                continue
            }
        canMove[v.ID] = true
    }
}
3.2.1 钉死清单(一):结构性钉死
这些值搬了根本不成立(不是"不划算",是"非法"):
①isLoweredGetClosurePtr—— 闭包指针
if v.Op.isLoweredGetClosurePtr() {
    // Must stay in the entry block.
    continue
}
背景:闭包捕获的变量放在堆上的"环境"里,函数被调用时,环境指针通过专用寄存器传入(ARM64 是 R26 / REGCTXT)。
func makeAdder(n int) func(int) int {
    return func(x int) int { return x + n }   // 捕获 n
}
ARM64 实现(arm64/ssa.go:1884):
case ssa.OpARM64LoweredGetClosurePtr:
    // Closure pointer is R26 (arm64.REGCTXT).
    ssagen.CheckLoweredGetClosurePtr(v)
入口块:
  clo = GetClosurePtr              ← 定义(= DX 的别名)
  ptr1 = OffPtr clo [8]; v1 = Load ptr1   ← 抢救捕获变量 1
  ptr2 = OffPtr clo [16]; v2 = Load ptr2  ← 抢救捕获变量 2
  ...全部消费完毕...
  (函数主体:clo 再无使用点)
为什么不能搬:这个指令几乎不生成代码,只是标记"这个值 = R26 寄存器"。R26 的内容随时会被后续指令覆盖,所以必须留在入口块、尽量最早执行。
② Phi / Arg / ArgIntReg / ArgFloatReg / Select0 / Select1 / SelectN
switch v.Op {
case OpPhi, OpArg, OpArgIntReg, OpArgFloatReg, OpSelect0, OpSelect1, OpSelectN:
    // Phis need to stay in their block.
    // Arg must stay in the entry block.
    // Tuple selectors must stay with the tuple generator.
    // SelectN is typically, ultimately, a register.
    continue
}
逐个说明:
| Op | 钉死原因 | 搬走的后果 |
|---|---|---|
| OpPhi | 参数与前驱边一一对应,块结构契约 | 边的对应关系错乱 → SSA 非法 |
| OpArg | 参数锚定函数入口的栈帧布局 | 帧布局 / 调试信息错乱 |
| OpArgIntReg/FloatReg | 入口寄存器是易逝资源,随时被覆盖 | 参数被踩 → 运行期错误结果 |
| OpSelect0/1 | 元组不物化,必须与生成器同在 | lower 展开失败或被迫额外物化 |
| OpSelectN | 多返回值里取第 N 个,最终就是寄存器 | 同上 |
Phi 为什么不能搬(Args[i] ↔ Preds[i] 的契约):
b1: x = 1        b2: x = 2
    |                |
    └───→ b3 ←──────┘
b3: p = Phi <int> v_x(b1边), v_y(b2边)
搬到别的块 → 那个块的前驱数量/顺序不同 → Args[i] 与"第 i 条前驱边"的映射立刻错位 → SSA 直接非法。
ArgIntReg 为什么危险(后果最隐蔽的一个):
b1(entry): v4 = ArgIntReg <int> [R0]   ← 必须最先执行,把 R0 抢救下来
b2:        ...任意使用 R0 的代码...      ← R0 立刻可被重新分配
b5:        use v4
搬到 b5 → 路径上任何指令碰到 R0 → 参数永久丢失,且极难排查。regalloc 里它和 Phi、GetClosurePtr 同列 mustBeFirst(regalloc.go:2309),连块内移动都不允许。
Select 为什么必须跟生成器绑在一起:
t  = AtomicAdd64 <(UInt64,Mem)> &x, 1, mem   ← 元组生成器
s0 = Select0 <UInt64> t                       ← 取 first
s1 = Select1 <Mem>    t                       ← 取 second
元组 t 不是真实寄存器值。lower 阶段把 t + s0 + s1 当一个整体展开成机器指令(如 ARM64 一条 LDADDAL)。把它们拆散 → 展开失败或被迫把元组真物化成寄存器。
3.2.2 钉死清单(二):寄存器压力闸门
for _, a := range v.Args {
    // SP and SB are special registers and have no effect on
    // the allocation of general-purpose registers.
    if a.needRegister() && a.Op != OpSB && a.Op != OpSP {
        narg++
    }
}
if narg >= 2 && !v.Type.IsFlags() {
    // Don't move values with more than one input, as that may
    // increase register pressure.
    // We make an exception for flags, as we want flag generators
    // moved next to uses (because we only have 1 flag register).
    continue
}
为什么"≥2 个寄存器输入"就不搬
下沉有代价:把 v 搬到更靠使用点的位置,v 自己的结果活得更短了(省),但 v 的每个输入都必须活到新位置(费)。
不搬:                          下沉到 b3:
b1: a,b 定义                    b1: a,b 定义
    v = Op a,b  ← 立即消费           |
    |                              b2: ...(a、b 必须一路活着!)
    b2: 中间代码                     |
    |                              b3: v = Op a,b   ← a、b、v 三者同时占寄存器
    b3: use v                        use v
- 不搬:a、b 在 b1 就被消费,
v的结果活 b1→b3(1 个值跨距离); - 下沉:
v的结果几乎不活,但 a、b 必须同时活到 b3,执行v那一刻 a、b、v 三者同时占寄存器。
一换一(1 个输入)划算,一换二(≥2 个输入)不划算 → 默认不搬。
SP / SB 被排除,因为它们是固定伪寄存器,不占用可分配的通用寄存器。
为什么 OpSB和OpSP不计数
因为SP和SB是两个特殊的寄存器, OpSB和OpSP没有实际对应的汇编指令,只不过在SSA阶段需要SB和SP一个统一的指令:
v1 = OpSP
v2 = OpConst64 {8}
v3 = OpOffPtr v1 [8] // 计算地址: SP + 8
v4 = OpLoad <TypeInt64> v3 mem // 从改地址读取64位值
为什么 flags 可以豁免
if narg >= 2 && !v.Type.IsFlags() {
//       ↑↑↑↑↑↑↑↑↑ 这个取反就是豁免
flags 的三个物理约束(1.7 节讲过)叠加后的效果:
- 只有一套 flag 寄存器;
- 不能 spill,要保存只能
SETcc物化成 bool(贵); - 任何后续比较/带标志运算都会无条件覆盖它。
看一个具体场景(v3 = CMPQ <flags> x, y 要下沉到 b3):
不搬(留在 b1):                    下沉(搬到 b3):
b1: v3 = CMPQ x, y                b1: (v3 搬走)
    |                                  |
    b2: v8 = CMPQ z, w  ← 踩掉!        b2: v8 = CMPQ z, w  ← 随便踩,无冲突
    |                                  |
    b3: If v3 → ...  (flags 已毁)      b3: v3 = CMPQ x, y  ← 生成后立刻使用
                                           If v3 → ...
不搬的后果:flagalloc 不得不在 b2 前插入 SETL 把 flags 物化到通用寄存器、过后重新比较还原 —— 很贵。
下沉后生成点紧贴使用点,被踩窗口归零,物化代码彻底省掉。
权衡对比:
| 普通值 | flags 值 | |
|---|---|---|
| 下沉收益 | 缩短结果活区间 | 缩短被踩窗口,避免被迫物化成 bool |
| 下沉代价 | 每个输入的活区间被拉长 | 同样有输入拉长的代价 |
| 结论 | ≥2 输入:代价 > 收益 → 不搬 | 收益(唯一的 flag 寄存器保命)压倒代价 → 照搬 |
注意:
CMPQ恰好有 2 个输入(x、y),本来会被>=2拦下。正是这个豁免让它能被搬。豁免 + 3.4 节的 ControlValues 扫描,两者缺一不可。
3.3 阶段 2:准备四件工具
// tighten.go:26-32, 74-84
startMem := f.Cache.allocValueSlice(f.NumBlocks())   // 每块开头的内存状态
endMem   := f.Cache.allocValueSlice(f.NumBlocks())
memState(f, startMem, endMem)
lca := makeLCArange(f)      // LCA 查询表
target := f.Cache.allocBlockSlice(f.NumValues())
idom := f.Idom()            // 支配树父节点
loops := f.loopnest()       // 循环信息
3.3.1 工具一:memState —— 算出每个块开头/结尾的内存状态
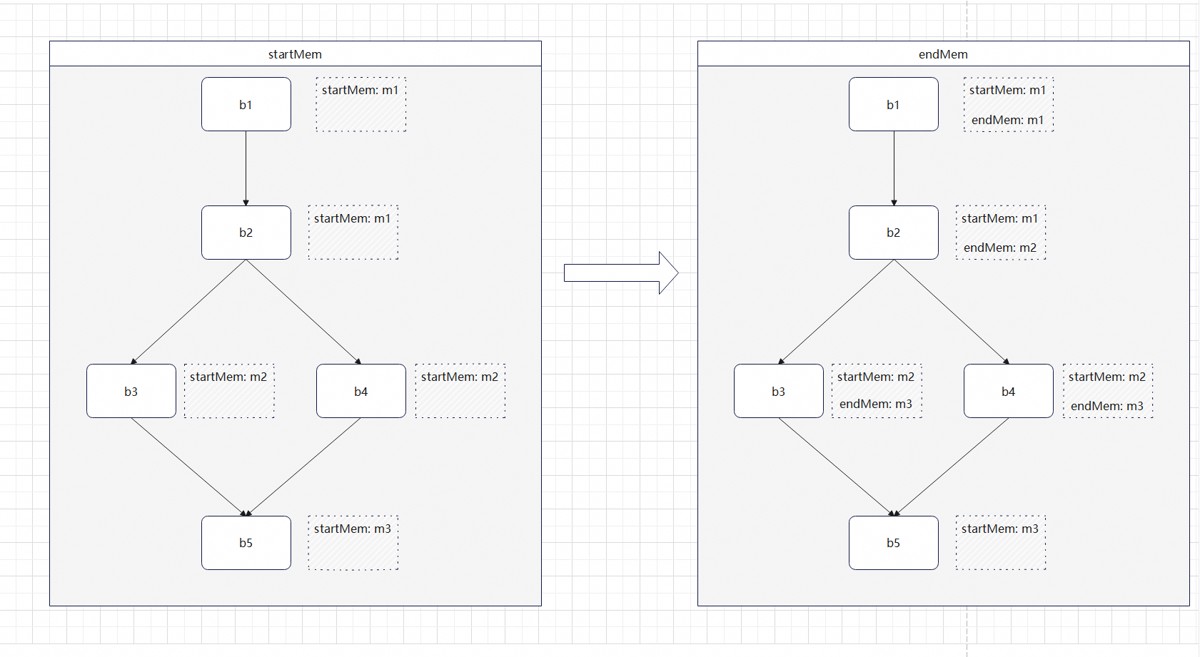
memState 要标记出每个块的入口/出口内存版本,它的底层概念是内存链(memory chain):
Go SSA 引入一个特殊的伪类型 TypeMem,表示"内存的当前状态"。
- 函数开头有一个
InitMem; - 每个
Store吃掉旧内存状态,吐出新内存状态; - 每个
Load吃掉一个内存状态(但不产出新的); - 分支汇合处用 memory Phi 汇合。
例子(实测:一条真实完整的内存链)
func f(p, q *int) int {
    *p = 1
    *q = 2
    x := *p
    y := *q
    return x + y
}
b1:
    v1  = InitMem <mem>                    ← 链头:内存版本 0
    v7  = Arg <*int> {p}
    v8  = Arg <*int> {q}
    v10 = Const64 <int> [1]
    v13 = Const64 <int> [2]
    v11 = NilCheck <*int> v7 v1            ← 使用 v1!
    v12 = Store <mem> {int} v11 v10 v1     ← 使用 v1,吐出 v12(版本 1)
    v14 = NilCheck <*int> v8 v12           ← 使用 v12
    v15 = Store <mem> {int} v14 v13 v12    ← 使用 v12,吐出 v15(版本 2)
    v16 = NilCheck <*int> v7 v15           ← 使用 v15
    v17 = Load <int> v16 v15               ← 使用 v15(不能使用 v1/v12)
    v18 = NilCheck <*int> v8 v15
    v19 = Load <int> v18 v15               ← 使用 v15
    v20 = Add64 <int> v17 v19
    v21 = MakeResult <int,mem> v20 v15     ← 返回值也带走 v15
    Ret v21
把每个值"吃掉谁"标出来,内存链就现形了:
v1 ──→ v12 ──→ v15 ──→ v21
        │       │
        ├───────┴──→ v17(Load x:吃 v15)
                     v19(Load y:吃 v15)
                     v11/v14/v16/v18(NilCheck:各吃对应版本)
如何识别一个"内存值"
// types/type.go:1549
func (t *Type) IsMemory() bool {
    if t == TypeMem || t.kind == TTUPLE && t.extra.(*Tuple).second == TypeMem {
        return true
    }
    if t.kind == TRESULTS {
        if types := t.extra.(*Results).Types; len(types) > 0 && types[len(types)-1] == TypeMem {
            return true
        }
    }
    return false
}
三种情况:
t == TypeMem—— 纯内存值(注意是指针相等!TypeMem是全局单例);TTUPLE且second == TypeMem—— 二元组,如(值, 新内存);TRESULTS且末位是TypeMem—— 多返回值函数调用的结果。
共同规律:内存永远排在最后。 这也解释了下面 MemoryArg() 为什么只检查最后一个参数——"内存排最后"是全局约定。
3.3.2 memState 算法本体:锚点 + 逆流泛洪
概念清楚了,memState(tighten.go:217-269)怎么把每个块的 startMem[]/endMem[] 填出来?关键洞察:内存版本只在这三种地方改变或合流——①InitMem(全函数唯一的时间零点)、②memory Phi(分支汇合的版本融合点)、③块内指令的产出(块内部的事)。所以不需要逐条指令模拟内存链——只要找到每个块入口的"版本号",块内的变化由使用者自己顺链去追。
第一步(:222-246):广撒网,找"锚点块"
遍历所有块的所有值,识别三类能直接确定 startMem 的证据:
if v.Op == OpPhi {
    if v.Type.IsMemory() { mem = v }          // 证据 1:memory Phi 本身
} else if v.Op == OpInitMem {
    mem = v                                    // 证据 2:InitMem(注释说其实非必需)
} else if a := v.MemoryArg(); a != nil && a.Block != b {
    mem = a                                    // 证据 3:块内指令的 mem 参数来自别的块
}
证据 3 最精妙:块 b 里某条指令吃了一个 mem,而这个 mem 定义在别的块——说明从那个定义点到这条指令之间,b 内部没有任何内存产出(否则吃到的会是块内的新版本)。所以 b 的入口内存就是那个外来的 mem。典型受益者是直线代码块:不汇合任何分支,入口内存就是"上一个块出口的内存",通过块内第一条带 mem 指令的参数直接暴露出来。
找到证据后写入 startMem[b] 并把 b 压入 changed 工作队列。若同一块发现两个不同的 startMem 候选 → Fatalf(:240)——内存链单版本不变式的后验检查,违反说明 SSA 本身已经坏了(fail-fast,1.7 节的老朋友)。
第二步(:249-268):泛洪传播,从已知块向前驱扩散
BFS 工作队列。弹出块 top,把它的 startMem 逆向推给所有前驱 p:
if mem.Op == OpPhi && mem.Block == top {
    endMem[pb.ID] = mem.Args[i]    // 特例:top 的入口是 memory Phi
} else {
    endMem[pb.ID] = mem            // 一般:前驱的出口 = top 的入口
}
if startMem[pb.ID] == nil {
    startMem[pb.ID] = endMem[pb.ID]  // 前驱自己没有锚点 → 顺带继承
    changed = append(changed, pb)    // 继续向前传播
}
- 一般情况:top 的入口内存来自单一前驱链 → 前驱 pb 的出口内存 = top 的入口内存(pb 到 top 之间没有别的版本切换点——有的话 top 的锚点就不是这个值了)。
- Phi 特例(:258-259):top 的入口是一个 memory Phi(
mem.Block == top说明 Phi 就住在 top)——这时"top 的入口"对不同前驱是不同版本!Phi 的第 i 个参数对应第 i 条入边(1.4 节的 Edge 双向索引不变式),所以前驱 pb(第 i 个前驱)的出口内存是mem.Args[i],而不是 Phi 本身。这一行是整个算法对"多前驱版本合流"的唯一处理。 - 终止:前驱的
endMem已非 nil 就跳过;前驱若 startMem 也空,就继承刚填的 endMem,继续向上游泛洪,直到队列耗尽。
边界:哪些块会留 nil(注释里的两个警告)
- 无后继的块(Exit/Ret/RetJmp):第二步永远不会推到它们 →
endMem = nil是"无人需要"而非"漏算"。 - 无限自循环且无 mem 操作的块(:196-205 的注释例子):
b1: → b2
b2: ← b1, b2     (自循环,体内没有任何带 mem 的指令)
b2 没有 Phi、没有外来 mem 参数 → 第一步抓不到锚点 → 无人向它传播 → startMem[b2] 永远是 nil。后果:若想搬一个带 mem 的值进来,startMem[t.ID] != mem 检查中 nil != mem → 拒绝搬移。保守但安全——宁可漏掉优化,不可搬到内存状态不明的块。
走一个小例子
b1: InitMem → v10 = Store v1 …          (出口内存 v10)
      ├→ b2: v20 = Load … v10           (锚点:mem 参数 v10 来自 b1)
      └→ b3: v21 = Store v1 …           (出口 v21)
b4(←b2,b3): v30 = Phi <mem> …           (锚点:memory Phi)
第一步锚点:b1(InitMem 证据)、b2(外来 mem 参数 v10)、b4(memory Phi)。第二步:弹 b4 → startMem 是 Phi 且住在 b4 → endMem[b2] = Phi.Args[0]、endMem[b3] = Phi.Args[1](各自沿入边取版本);弹 b3 → 向 b1 传播……最终所有非出口块的表都填满,且每个 memory Phi 的参数与各前驱出口精确对齐。
一句话:memState = “锚点 + 逆流泛洪”——第一步靠三类证据(memory Phi、InitMem、外来 mem 参数)钉住一批块的入口内存,第二步沿前驱边 BFS 逆向传播(Phi 处按入边序号拆分版本),O(块数+边数) 一遍填完两张表;病态块留 nil 让硬检查拒绝搬移——又一次 fail-safe 优于乐观优化。
3.4 阶段 3:计算目标位置 target
// tighten.go:93-122
// Compute target locations (for moveable values only).
// target location = the least common ancestor of all uses in the dominator tree.
for _, b := range f.Blocks {
    for _, v := range b.Values {
        for i, a := range v.Args {
            if !canMove[a.ID] { continue }
            use := b
            if v.Op == OpPhi {
                use = b.Preds[i].b          // ★ Phi 特例, phi是一个虚拟的SSA,不产生实际的指令,真正是用的地方是在前驱边
            }
            if target[a.ID] == nil {
                target[a.ID] = use
            } else {
                target[a.ID] = lca.find(target[a.ID], use)
            }
        }
    }
    for _, c := range b.ControlValues() {   // ★ 第二个循环
        if !canMove[c.ID] { continue }
        if target[c.ID] == nil {
            target[c.ID] = b
        } else {
            target[c.ID] = lca.find(target[c.ID], b)
        }
    }
}
3.4.1 扫描方向:不是"找值的使用者",而是"扫每条指令的参数"
遍历每个块 b 的每条指令 v,再看 v.Args 里的每个 a —— 于是发现"a 的一个使用点在 b"。
3.4.2 走一遍例子
func f(c1, c2 bool) int {
    t := 42
    if c1 { ... }        // b2, b3
    if c2 {
        return t + 1     // b5 使用点 1
    }
    return t + 2         // b6 使用点 2
}
CFG:                 支配树:
      b1                  b1
     /  \                / | \
    b2   b3             b2 b3 b4
     \   /                  / \
      b4                   b5  b6
     /  \
    b5    b6
     \   /
      b7
| 扫描到 | 发现 | target[t] |
|---|---|---|
| b1~b4 | 无使用 | nil |
| b5 | v = Add t, 1 → t 的使用点 b5 | b5(第一个使用点直接初始化) |
| b6 | v = Add t, 2 → 使用点 b6 | lca.find(b5,b6) = b4 |
最终 target[t] = b4,t 从 b1 搬到 b4,活区间从"横跨第一个菱形"缩短到"紧贴使用点"。
反例:如果 b2 里也有一个 use t,则 target = lca(lca(b5,b6), b2) = lca(b4,b2) = b1 —— 等于没动(t 本来就在 b1)。
只要有一个使用点在"高位",LCA 就被拽回去 —— 这正是 LCA 保证合法性的方式。
3.4.4 ★ 第二个循环:ControlValues(控制值也是使用点)
for _, c := range b.ControlValues() { ... target[c.ID] = b ... }
ControlValues()(block.go:171-179)返回块的控制输入(最多 2 个):
func (b *Block) ControlValues() []*Value {
    if b.Controls[0] == nil { return b.Controls[:0] }
    if b.Controls[1] == nil { return b.Controls[:1] }
    return b.Controls[:2]
}
为什么必须单独扫:回忆 flags 的例子 ——
b4: v3 = CMPQ <flags> a, b    ← v3 不在任何指令的 Args 里!
    If v3 → b5, b6            ← v3 是 b4 的控制值
v3 从不出现在任何 v.Args 中,只挂在块的控制上。如果只扫 Args,v3 一个使用点都找不到 → target 为 nil → 永远不搬 → 整个 flags 豁免形同虚设。
完整例子:
b1:
    x = Load ...
    y = Load ...
    v3 = CMPQ <flags> x, y      ← 生成点,离分支很远
    |
    v
b2:
    v8 = CMPQ <flags> z, w      ← ★ 另一个比较,踩掉唯一的 flag 寄存器!
    If v8 → b3, b4
b3:
    If v3 → b5, b6              ← v3 的使用点(控制值)
扫到 b3 的 Controls[0] = v3 → target[v3] = b3 → 搬移后:
b1: x, y 加载
    |
b2: v8 = CMPQ z,w; If v8 → b3, b4    ← 随便踩,不再冲突
b3: v3 = CMPQ x,y                     ← 生成后立刻使用
    If v3 → b5, b6
3.5 阶段 4:循环保护
// tighten.go:124-143
// If the target location is inside a loop,
// move the target location up to just before the loop head.
if !loops.hasIrreducible {
    // Loop info might not be correct for irreducible loops. See issue 75569.
    for _, b := range f.Blocks {
        origloop := loops.b2l[b.ID]
        for _, v := range b.Values {
            t := target[v.ID]
            if t == nil { continue }
            targetloop := loops.b2l[t.ID]
            for targetloop != nil && (origloop == nil || targetloop.depth > origloop.depth) {
                t = idom[targetloop.header.ID]
                target[v.ID] = t
                targetloop = loops.b2l[t.ID]
            }
        }
    }
}
为什么需要:防止"下沉"变成"掉进热循环"
func f(xs [][]int) int {
    sum := 0
    a := len(xs) * 2              // ← 定义在任何循环之外
    for i := range xs {           // 外层循环
        for j := range xs[i] {    // 内层循环
            sum += a + xs[i][j]   // ← a 在最深处被使用
        }
    }
    return sum
}
b1 (entry)   a = len(xs)*2        ← 定义点(不在任何循环)
 |
b2 外层 header ◄──────────────┐
 |                            |
b3 内层 header ◄─────┐        |
 |                   |        |
b4 内层 body  use a ─┘        |    ← a 的唯一使用点
 |                            |
b5 外层 latch ────────────────┘
- 外层循环:header = b2,depth 1
- 内层循环:header = b3,depth 2
idom[b3] = b2,idom[b2] = b1
没有保护:LCA 算出 target[a] = b4 → a 被搬进 b4 → 从"整个函数算 1 次"变成"内层循环每轮算一次"(N×M 次)。tighten 本意省寄存器,却换来指数级性能倒退。
有保护(逐轮追踪):
| 轮次 | targetloop | 条件 | 动作 | t |
|---|---|---|---|---|
| 1 | 内层(depth 2) | ✓(origloop==nil 恒真) | t = idom[b3] = b2 | b2 |
| 2 | 外层(depth 1) | ✓(origloop==nil 仍恒真) | t = idom[b2] = b1 | b1 |
| 3 | b2l[b1] = nil | ✗ | 退出 | b1 |
最终 target[a] = b1 = 原位置 → 不搬。✓
3.6 阶段 5:执行搬移
// tighten.go:145-174
// Move values to target locations.
for _, b := range f.Blocks {
    for i := 0; i < len(b.Values); i++ {
        v := b.Values[i]
        t := target[v.ID]
        if t == nil || t == b {
            // v is not moveable, or is already in correct place.
            continue
        }
        if mem := v.MemoryArg(); mem != nil {
            if startMem[t.ID] != mem {
                // We can't move a value with a memory arg unless the target block
                // has that memory arg as its starting memory.
                continue
            }
        }
        // Move v to the block which dominates its uses.
        t.Values = append(t.Values, v)
        v.Block = t
        last := len(b.Values) - 1
        b.Values[i] = b.Values[last]
        b.Values[last] = nil
        b.Values = b.Values[:last]
        changed = true
        i--
    }
}
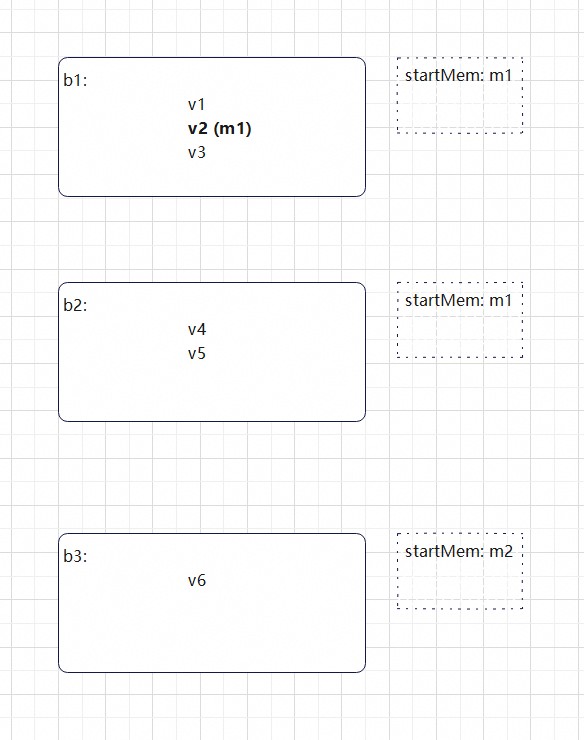
3.6.1 内存一致性检查
if mem := v.MemoryArg(); mem != nil {
    if startMem[t.ID] != mem { continue }
}
带内存参数的值(Load/Store 等)不能随便搬 —— 必须保证目标块开头的内存状态,恰好等于这个值的内存参数。
例子:
b1:
    v1 = InitMem
    v2 = Store <mem> p, 1, v1      ← 内存推进到 v2
    |
b2:  (startMem[b2] = v2)
    v3 = Load <int> q, v2          ← 吃掉 v2
若想把 v3 搬到某个 startMem 是 v1 的块 → startMem[t] != v2 → 拒绝搬移。
3.6.2 搬移动作
t.Values = append(t.Values, v)   // ① 追加到目标块末尾
v.Block = t                      // ② 更新归属
// ③ 从原块删除(swap-remove)
last := len(b.Values) - 1
b.Values[i] = b.Values[last]
b.Values[last] = nil
b.Values = b.Values[:last]
3.7e0ceba8139:narg 判定从!a.rematerializeable()换成needRegister() && !SB && !SP,对哪些 Op 产生影响
rematerializeable 判断的是: 可无限次免费重造,包括:
| 类型 | 说明 |
|---|---|
MOVQconst/MOVLconst | 整数常量,参数不占用寄存器 |
MOVSSconst/MOVSDconst | 浮点常量,参数不占用寄存器 |
LEAQ/LEAL/LEAW | 地址合成,参数只许 SP/SB,LEAQ 8(SP), AX,参数最多占用1 个寄存器,且常常是 0 个 |
LoweredGetCallerPC/LoweredGetCallerSP/LoweredHasCPUFeature | 读一个运行时恒定值,MOVQ (param-8)(SP), 占用1 个通用寄存器 |
needRegister的判断是:此参数是否需要通用寄存器
影响的指令: 如果参数需要两个及以上的通用寄存器,则不搬迁:
搬移资格全景表:哪些 v 之前本来不搬,现在可能搬
一个 v 能否搬要过五道闸门:①钉死清单(nilCheck/Phi/Arg/GetClosurePtr/tuple选择器)→②narg>=2 闸门→③startMem 检查(新增)→④target 严格支配 use(v)→⑤loopMatrix 循环保护。e0ceba8139 同时动了①②③三处(删整类拦截、换判定、加 startMem),综合影响如下:
| v 的类型 | v.MemoryArg() | 旧代码为什么禁搬 | 新代码的资格路径 | 典型形态 |
|---|---|---|---|---|
| Load 类(MOVQload 等) | 非 nil(吃 mem) | 双重锁死:计数前 MemoryArg()!=nil 整类拦截;即使放行 mem 也计 narg | 整类拦截删除+mem 计 0。唯一 GP 参数+startMem 一致 → 可搬 | b1: x=Load(mem); if…{ b2: use(x) }——issue 56620 原型,15% 收益的核心场景 |
| Call 结果(CALLstatic 的 SelectN) | 非 nil(吃 mem) | 同上双重锁死 | 同上;Call 本体因副作用留原块,其结果值可下沉 | b1: r=Call(...); if…{ b2: use(r) } |
| Store 类(MOVQstore) | 非 nil(store 返回新 mem) | 同上双重锁死 | SP/SB 计 0;但 store 的结果只有后续 mem 链吃它,通常无独立使用点,实际很少成为搬移候选 | 栈对象访问下沉 |
| 吃 SP/SB 的值(store 型 v) | 非 nil(store 吃 mem) | SP/SB 计 narg → narg 虚高被拦 | SP/SB 计 0;store 类还需 startMem 一致 | 栈对象访问下沉 |
| 吃 flags 的值(CMOVQxx/ADCQ) | nil(flags 不是 mem) | flags 计 narg:CMOVQxx c,x,f 两个计数参数 → narg=2 被拦 | flags 计 0 → narg 降到 1 → 过闸门 | 条件选择的值下沉到使用分支 |
| 吃常量的计算(ADDQ c1,c2) | nil | 常量计 0 → narg=0 放行 | 常量计 1 → narg=2 被拦(方向相反!但恰好正确:两个常量可各自下沉,不该连人带马整体搬) | — |
一句话总结
tighten把每个合法可搬的值,下沉到"支配其所有使用点的最深块"(= 离使用点最近的合法位置),以此缩短值的存活区间、减少寄存器溢出;过程中用"钉死清单"守住结构性契约与副作用位置,用narg>=2守住寄存器压力(flags 因只有一套标志寄存器而豁免),用 LCA 表做到 O(1) 定位,用循环保护防止沉进更深的循环,并在不动点迭代中反复收敛。
到此这篇关于Go 编译器SSA 优化tighten pass的详细过程的文章就介绍到这了,更多相关Go 编译器 SSA 优化内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!