
MySQL慢查询从定位问题到EXPLAIN的排查指南
作者:西凉的悲伤
前言
在 Java 后端开发中,数据库慢查询是非常常见的性能问题。例如,接口原本几十毫秒就能返回,突然变成几秒;订单列表查询很慢;分页越往后越慢;或者 SQL 明明建立了索引,却依然执行缓慢。
要系统地排查慢查询,需要掌握两件事:
- 如何定位慢 SQL,并判断慢在哪里。
- 如何通过
EXPLAIN理解 SQL 的执行计划,找到可能的性能瓶颈。
本文以 MySQL 8.0 + InnoDB 为主,结合企业订单、员工列表等 Java 后端业务场景,详细解释排查流程,以及 EXPLAIN 各列的含义、常见值和判断方法。
一、什么是慢查询?
慢查询通常指执行时间超过某个阈值的 SQL。
例如,某个系统把执行时间超过 1 秒的 SQL 记录为慢查询:
SELECT *
FROM car_order
WHERE company_id = 1001
ORDER BY create_time DESC
LIMIT 20;
但要注意,慢查询不等于 SQL 一定没有使用索引。
即使 SQL 使用了索引,也可能因为以下原因变慢:
- 索引设计不合理,扫描了大量记录。
- 查询返回的数据太多,网络传输和对象映射耗时较高。
- 出现大量回表。
- 排序或分组产生了额外开销。
- 深分页需要跳过大量数据。
- 数据库存在锁等待。
- 磁盘 I/O、CPU 或内存资源紧张。
- SQL 本身执行很快,但 Java 端的连接池等待、网络传输或结果集处理很慢。
因此,排查时不能只看 SQL,也不能只看索引,而应该从应用到数据库逐层分析。
二、慢查询排查的完整流程
推荐按照下面的顺序排查。
定位慢 SQL
从应用日志、APM、数据库慢查询日志中,找到具体 SQL、执行时间、参数和调用频率。
判断耗时发生在哪一层
区分 SQL 执行、锁等待、连接池等待、网络传输和 Java 业务处理。
查看表结构和索引
执行 SHOW CREATE TABLE、SHOW INDEX,确认索引是否存在、字段顺序是否合理。
使用 EXPLAIN 分析执行计划
重点看 type、possible_keys、key、key_len、rows、filtered、Extra。
检查实际执行情况
在合适环境下使用 EXPLAIN ANALYZE,对比估算行数和实际行数、各步骤耗时。
优化并验证
调整 SQL、索引、分页方式或事务设计,然后在可比较的条件下验证性能改善。
一个非常重要的原则是:先定位,再分析,再优化,最后验证。不要一看到 SQL 慢就盲目增加索引。
2.1 第一步:确认慢 SQL 是什么
在 Java 项目中,可以从以下地方定位:
- Spring Boot 应用日志。
- APM 监控平台中的慢接口与数据库调用链。
- MySQL 慢查询日志。
- 数据库监控平台。
- MyBatis 或 JDBC SQL 日志(注意生产环境不宜无节制地输出大量 SQL 参数)。
需要收集的信息包括:
| 信息 | 作用 |
|---|---|
| SQL 文本 | 确认查询逻辑 |
| 参数值 | 判断数据分布和执行计划差异 |
| 执行耗时 | 判断问题严重程度 |
| 调用频率 | 区分单次慢与高频累积开销 |
| 返回行数 | 判断结果集是否过大 |
| 表的数据量 | 判断扫描规模 |
| 并发情况 | 判断是否与资源竞争有关 |
例如,同一条 SQL:
SELECT *
FROM car_order
WHERE company_id = ?
  AND status = ?;
当参数为某个小企业时,可能只返回 10 条记录;当参数为大型企业时,可能返回 30 万条记录。
SQL 文本完全相同,执行时间却可能差异很大。因此,排查时要关注真实参数,而不只是 SQL 模板。
2.2 第二步:开启和检查 MySQL 慢查询日志
先查看相关配置:
SHOW VARIABLES LIKE 'slow_query_log';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'slow_query_log_file';
SHOW VARIABLES LIKE 'log_output';
主要关注:
slow_query_log:是否启用慢查询日志。long_query_time:超过多少秒记录为慢查询。slow_query_log_file:慢查询日志文件路径。log_output:日志输出位置,例如文件或表。
如果当前实例允许修改配置,可以在评估后启用:
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 1;
这里设置的阈值是 1 秒,仅作为示例。
注意:SET GLOBAL 修改的是运行中的全局变量,具体是否立即影响现有连接、是否持久化,以及重启后的行为,需要根据变量属性和 MySQL 版本确认。生产环境应该通过统一配置管理实施变更,而不是直接随意修改。
慢查询日志也不一定记录所有高频但单次较快的 SQL。例如,一条 SQL 每次只耗时 50 毫秒,但每秒执行数千次,依然可能是重要的性能瓶颈。
2.3 第三步:先排除锁等待与资源问题
有些 SQL 看起来执行了很久,实际上并不是索引查找慢,而是在等待其他事务释放锁。
可以先查看当前活动:
SHOW FULL PROCESSLIST;
重点关注:
Command:连接当前执行的操作类型。Time:当前状态持续的时间。State:当前执行状态。Info:当前 SQL 文本。
例如,如果发现某条查询长时间处于锁等待相关状态,就要继续检查事务、锁和阻塞链,而不是直接修改索引。
如果怀疑 InnoDB 锁问题,还可以检查:
SHOW ENGINE INNODB STATUS;
此外,还应结合数据库监控查看 CPU、磁盘 I/O、连接数、Buffer Pool 命中情况等。
三、EXPLAIN 到底是什么?
EXPLAIN 是 MySQL 提供的执行计划分析工具,可以让我们了解数据库准备如何执行一条 SQL。
例如:
EXPLAIN
SELECT id, order_no, amount
FROM car_order
WHERE company_id = 1001
  AND status = 1
ORDER BY create_time DESC
LIMIT 20;
对于常规的表格输出,MySQL 8.0 的 EXPLAIN 通常包含以下 12 列:
| 列名 | 中文含义 | 重点程度 |
|---|---|---|
id | 查询块的标识 | 一般 |
select_type | 查询类型 | 一般 |
table | 当前分析的表或派生表 | 一般 |
partitions | 命中的分区 | 分区表重点关注 |
type | 表的访问方式 | 非常重要 |
possible_keys | 可能使用的索引 | 重要 |
key | 实际选择的索引 | 非常重要 |
key_len | 使用的索引键长度 | 重要 |
ref | 与索引进行比较的列或常量 | 重要 |
rows | 预计检查的行数 | 非常重要 |
filtered | 预计经过表条件过滤后保留的比例 | 重要 |
Extra | 其他执行信息 | 非常重要 |
要注意:一条 SQL 如果涉及多张表,EXPLAIN 通常会为每张参与执行的表输出一行。复杂 SQL 还可能包含子查询、派生表等对应的执行计划信息。
下面逐列讲解,并重点说明每列可能出现的值。
四、EXPLAIN 各列详细解析
4.1id:查询块标识
id 表示查询中 SELECT 查询块的标识。
例如:
EXPLAIN
SELECT *
FROM car_order
WHERE id = 1001;
可能得到:
| id | select_type | table | type | key |
|---|---|---|---|---|
| 1 | SIMPLE | car_order | const | PRIMARY |
这里的 id = 1 表示这是一个简单查询中的查询块。
再看一个子查询:
EXPLAIN
SELECT *
FROM car_order
WHERE company_id IN (
    SELECT id
    FROM company
    WHERE status = 1
);
这个查询可能会被优化器改写,例如转换为半连接,所以不能保证一定出现两个不同的 id。
id的值怎么看?
1、2、3等:不同查询块的标识。- 相同
id:可能属于同一个查询块。 NULL:某些执行计划节点可能出现,例如用于表示其他节点的附加信息。
注意:不要简单认为 id 越大就越慢,也不要认为必须严格按照 id 从小到大执行。 复杂 SQL 的实际执行顺序要结合 select_type、表访问顺序和完整执行计划分析。
4.2select_type:查询类型
该列用于描述当前查询块属于哪种查询结构。
常见值如下:
| 值 | 含义 | 示例或说明 |
|---|---|---|
SIMPLE | 简单查询块 | 没有子查询或 UNION 的简单 SELECT |
PRIMARY | 最外层查询块 | 复杂查询中的最外层 SELECT |
SUBQUERY | 非关联子查询 | 子查询不依赖外层查询的当前行 |
DEPENDENT SUBQUERY | 依赖外层查询的子查询 | 子查询引用外层字段 |
DERIVED | 派生表 | FROM (SELECT ...) t |
UNION | UNION 中非第一个查询块 | 多个查询结果合并 |
UNION RESULT | UNION 的结果集合 | 表示合并后的结果 |
MATERIALIZED | 物化子查询结果 | 优化器将子查询结果物化后使用 |
DEPENDENT UNION | 依赖外层查询的 UNION 分支 | 复杂子查询场景 |
例如:
SELECT *
FROM (
    SELECT company_id, COUNT(*) AS total
    FROM car_order
    GROUP BY company_id
) t
WHERE t.total > 10;
内部的 SELECT 可能显示为 DERIVED,外部查询可能显示为 PRIMARY。
哪些值需要重点关注?
如果看到:
DEPENDENT SUBQUERY
建议检查是否存在关联子查询重复执行的成本。例如:
SELECT *
FROM company c
WHERE EXISTS (
    SELECT 1
    FROM car_order o
    WHERE o.company_id = c.id
);
这里子查询引用了外层的 c.id。不过,MySQL 可能对 EXISTS 进行半连接等优化,因此出现依赖子查询并不一定意味着性能差。
如果看到 DERIVED,也不代表一定有问题。应该进一步判断派生表是否需要物化、数据量有多大,以及是否可以通过其他 SQL 写法改善执行计划。
4.3table:当前分析的表
该列显示执行计划当前处理的表、表别名或派生表。
例如:
SELECT o.id, c.company_name
FROM car_order o
JOIN company c ON o.company_id = c.id;
执行计划可能出现:
| table | 含义 |
|---|---|
o | 订单表的别名 |
c | 企业表的别名 |
如果 SQL 中使用了:
FROM (SELECT ...) t
那么 table 也可能显示为 t 或其他派生表标识。
如何利用这一列?
如果 SQL 涉及多张表,可以先识别每一行对应哪张表,再查看它的 type、key 和 rows。
尤其是多表 JOIN,需要关注:
- 哪张表先被读取。
- 后续表是否通过合适的索引匹配。
- 是否出现大量行与行之间的匹配。
- 是否因为连接顺序和过滤能力导致处理了过多数据。
4.4partitions:命中的分区
如果表采用了分区,例如按月份对订单进行分区,那么 partitions 会显示查询可能访问的分区。
例如:
SELECT *
FROM car_order
WHERE create_time >= '2026-10-01'
  AND create_time <  '2026-11-01';
如果表按时间分区,并且优化器能够根据条件裁剪分区,结果可能类似:
| partitions |
|---|
p202610 |
这里仅作示意,p202610 是假设的分区名。
常见情况:
NULL:可能表示非分区表,或者没有显示具体分区。- 一个分区名:查询涉及该分区。
- 多个分区名:查询需要访问多个分区。
如果按月分区的表查询某个月的数据,却需要扫描大量月份的分区,就应该检查分区键、查询条件以及分区裁剪是否生效。
但要注意,分区不能替代索引。分区主要帮助缩小需要访问的数据分区,分区内部仍然可能需要全表扫描或使用索引。
4.5type:访问方式——最重要的字段之一
type 表示 MySQL 访问当前表时使用的访问方式。官方文档中对应的 JSON 字段名为 access_type。
这是判断执行计划是否存在潜在问题的重要字段。
常见值包括:
| type | 含义 | 一般判断 |
|---|---|---|
system | 特殊的单行系统表访问 | 通常开销很低 |
const | 通过主键或唯一索引等值查找,至多一行 | 通常非常高效 |
eq_ref | JOIN 中使用主键或唯一非空索引匹配一行 | 通常高效 |
ref | 通过非唯一索引进行等值匹配 | 常见且通常合理 |
fulltext | 使用全文索引访问 | 取决于搜索场景 |
ref_or_null | 通过索引查找指定值,同时查找 NULL | 取决于查询 |
index_merge | 合并多个索引的访问结果 | 需结合具体计划 |
unique_subquery | 某些 IN 子查询优化后的唯一索引访问 | 通常较高效 |
index_subquery | 某些 IN 子查询通过索引查找 | 需结合具体计划 |
range | 索引范围扫描 | 常见且通常合理 |
index | 全索引扫描 | 需要判断扫描规模 |
ALL | 全表扫描 | 大表慢查询中重点排查 |
不同版本和执行计划可能出现其他值,例如 hash_join 相关信息在 MySQL 8.0 中主要通过 FORMAT=TREE 展示,而不是传统表格的 type 列。
①const:常量级查找
例如:
SELECT *
FROM car_order
WHERE id = 1001;
如果 id 是主键,可能出现:
type = const
key  = PRIMARY
rows = 1
对于唯一索引的等值查询,如果条件保证最多匹配一条记录,也可能出现类似的访问方式。
②eq_ref:关联查询中的高效访问
例如:
SELECT o.id, c.company_name
FROM car_order o
JOIN company c ON o.company_id = c.id;
如果 company.id 是主键,执行 JOIN 时可能通过主键为每个订单匹配唯一的一条企业记录,company 对应的访问方式就可能是 eq_ref。
③ref:普通索引等值查询
假设:
CREATE INDEX idx_car_order_company
ON car_order (company_id);
执行:
SELECT *
FROM car_order
WHERE company_id = 1001;
可能出现:
type = ref
key  = idx_car_order_company
因为同一个企业可能有多条订单记录,所以这里不是唯一索引的单行查找。
ref 很常见,不代表 SQL 有问题。
④range:范围扫描
例如:
SELECT *
FROM car_order
WHERE create_time >= '2026-10-01'
  AND create_time <  '2026-11-01';
如果存在:
CREATE INDEX idx_car_order_create_time
ON car_order (create_time);
可能出现:
type = range
key  = idx_car_order_create_time
这意味着数据库利用索引查找指定范围的数据。
range 经常出现在日期范围、数值范围和部分 IN 查询中。
⑤index:扫描整个索引
例如:
SELECT create_time
FROM car_order;
如果某个索引包含 create_time,优化器可能选择扫描整个索引来返回数据。
这种方式可能比扫描完整数据行更省空间,但它仍然可能扫描大量索引记录。
因此:
index 不等于“查询很快”,也不等于“只扫描了一条索引记录”。
⑥ALL:全表扫描
例如:
SELECT *
FROM car_order
WHERE remark = 'test';
如果 remark 没有合适的索引,可能出现:
type = ALL
key  = NULL
这意味着执行计划选择全表扫描。
但也不能仅凭 ALL 就认定 SQL 有问题。如果表很小,或者查询需要返回表中绝大多数记录,全表扫描可能是更合理的方案。
实际排查重点是:大表、低选择性过滤、扫描行数巨大、接口耗时高的 ALL。
4.6possible_keys:可能使用的索引
该列列出优化器认为有可能用于当前表访问的索引。
例如:
SELECT *
FROM car_order
WHERE company_id = 1001
  AND status = 1;
如果存在:
CREATE INDEX idx_company
ON car_order (company_id);

CREATE INDEX idx_status
ON car_order (status);

CREATE INDEX idx_company_status
ON car_order (company_id, status);
执行计划中的 possible_keys 可能显示:
idx_company,idx_status,idx_company_status
这里要注意两个问题。
第一,possible_keys 不等于最终使用的索引。
优化器可能考虑多个索引,最终选择其中一个,也可能认为全表扫描更划算。
第二,possible_keys = NULL 不一定代表数据库完全没有索引。
例如,查询条件没有使用可用于定位数据的索引列,或者优化器认为现有索引不适合当前访问方式,就可能出现 NULL。
排查建议
如果你认为 SQL 应该使用某个索引,但 possible_keys 中没有它,可以检查:
WHERE条件是否包含索引的左侧前缀。- 是否对索引列使用了函数或计算。
- 字段与参数的数据类型是否匹配。
- 查询条件是否能够构造索引范围。
- 索引是否确实存在。
- 是否需要检查统计信息。
4.7key:实际使用的索引
这是最值得关注的字段之一。
假设:
CREATE INDEX idx_company_status
ON car_order (company_id, status);
执行:
EXPLAIN
SELECT *
FROM car_order
WHERE company_id = 1001
  AND status = 1;
可能得到:
possible_keys = idx_company_status
key           = idx_company_status
说明优化器选择了这个联合索引。
常见值:
| key 的值 | 含义 |
|---|---|
PRIMARY | 使用主键索引 |
idx_company_status | 使用指定的普通或联合索引 |
uk_order_no | 使用指定的唯一索引 |
NULL | 没有选择索引作为当前访问路径 |
key = NULL应该怎么办?
不要直接使用 FORCE INDEX 强制指定索引。
建议先检查:
- 表的数据量是否很小。
- 查询是否返回大部分记录。
possible_keys是否为空。- 索引字段顺序是否与查询条件匹配。
- 索引统计信息是否准确。
- 是否存在函数、类型转换或其他不利于索引范围访问的写法。
只有经过测试,确认优化器选择不合理,并且强制索引在代表性数据上确实更优,才考虑索引提示等手段。
4.8key_len:实际使用的索引键长度
key_len 表示执行计划使用的索引键长度,单位通常是字节。
它是分析联合索引时非常有价值的字段,因为可以帮助判断索引的哪些部分参与了定位。
假设:
CREATE TABLE demo_order (
    id BIGINT NOT NULL PRIMARY KEY,
    company_id BIGINT NOT NULL,
    status TINYINT NOT NULL,
    create_time DATETIME NOT NULL
);
创建索引:
CREATE INDEX idx_company_status_time
ON demo_order (company_id, status, create_time);
字段的大致存储长度:
| 字段 | 类型 | 常见索引键长度 |
|---|---|---|
company_id | BIGINT NOT NULL | 8 字节 |
status | TINYINT NOT NULL | 1 字节 |
create_time | DATETIME NOT NULL | 5 字节 |
在这个示例中,如果执行计划实际使用了前两列,key_len 可能是 9;如果三个字段均参与使用,可能是 14。
这只是简化示例,实际值还会受到字段定义、可空性、字符集、变长字段长度编码等因素影响。VARCHAR 字段还需要考虑字符集的最大字节数以及长度存储信息。
如何通过key_len判断联合索引使用情况?
假设索引为:
(company_id, status, create_time)
分别执行:
-- 查询一
WHERE company_id = 1001;

-- 查询二
WHERE company_id = 1001
  AND status = 1;

-- 查询三
WHERE company_id = 1001
  AND status = 1
  AND create_time >= '2026-10-01';
如果字段定义符合前面的示例,并且执行计划使用对应的索引前缀,那么 key_len 可能依次显示:
8
9
14
不过,不能机械地用 key_len 推断所有联合索引列是否被用于精确定位,因为范围条件、可空字段和索引访问细节都会影响结果。
最重要的是结合 key、key_len、ref 和实际 SQL 一起判断。
4.9ref:索引查找使用的比较对象
ref 表示数据库使用什么值或字段,与 key 对应的索引键进行比较。
例如:
SELECT *
FROM car_order
WHERE company_id = 1001;
如果使用 idx_company,ref 可能显示:
const
表示使用常量进行匹配。
对于 JOIN:
SELECT o.id, c.company_name
FROM car_order o
JOIN company c ON o.company_id = c.id;
访问 company 表时,ref 可能显示:
db.o.company_id
具体格式取决于数据库及执行计划的显示方式。
常见值包括:
| ref 的值 | 含义 |
|---|---|
const | 使用常量匹配索引 |
db.table.column | 使用另一张表的列匹配索引 |
func | 使用函数或表达式结果匹配索引 |
NULL | 当前访问方式没有对应的比较引用,或不适用 |
如果看到 func,可以进一步执行:
SHOW WARNINGS;
结合扩展执行计划信息,检查比较条件是否涉及函数、运算表达式或类型转换。
4.10rows:预计需要检查多少行
这是判断扫描规模的核心字段之一。
假设执行计划显示:
type = ref
rows = 500000
意味着优化器预计需要检查大约 50 万行。
虽然它选择了索引,但预计检查的数据量依然很大。
这可能是查询慢的原因之一。
rows具体代表什么?
它是优化器估算的、执行当前表访问预计需要检查的行数,而不是最终返回给应用程序的行数。
例如:
SELECT *
FROM car_order
WHERE company_id = 1001
  AND status = 1;
假设某个企业共有 50 万条订单,其中只有 100 条状态为 1。
如果执行计划使用 (company_id) 索引,再通过其他条件过滤,可能预计检查大量记录,最后只返回少量结果。
如果存在更匹配的联合索引:
CREATE INDEX idx_company_status
ON car_order (company_id, status);
优化器就可能直接缩小索引查找范围,减少需要检查的记录。
但需要强调,rows 是估算值,尤其在 InnoDB 中并不保证准确。
如何判断rows是否过大?
不能只看一个固定阈值,而应该结合表的数据量和查询结果判断。
例如:
| 预计 rows | 实际返回行数 | 初步判断 |
|---|---|---|
| 1 | 1 | 单行查找,通常较理想 |
| 100 | 80 | 可能比较合理 |
| 100000 | 20 | 需要检查过滤效率 |
| 1000000 | 800000 | 可能本来就需要读取大量数据 |
如果预计扫描 10 万行,最终只返回 20 行,就值得进一步检查索引设计、过滤条件和实际执行情况。
不过,对于覆盖索引、索引条件下推、范围扫描等不同访问方式,扫描行数的具体含义会有差异,不能只靠这个字段下结论。
4.11filtered:预计过滤比例
filtered 表示预计经过当前表的相关过滤条件后,保留下来的行所占的百分比。
例如:
rows     = 100000
filtered = 1.00
意思是优化器估计访问阶段涉及约 100000 行,经过相应的表条件过滤后,保留比例约为 1%。
估算保留行数为:
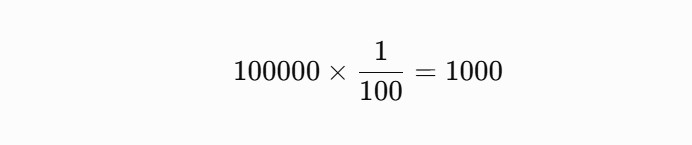
如果是 JOIN 查询,这个估算结果有助于理解后续表需要处理多少匹配行。官方文档也通过 rows × filtered 说明这一估算关系。
常见值:
100.00:预计没有进一步过滤掉行,或过滤比例为 100%。50.00:预计保留 50%。1.00:预计保留 1%。0.10:预计保留 0.1%。
注意,filtered 越低不一定代表 SQL 越慢。
例如,索引扫描 1000 行,最终只保留 10 行,过滤效率可能很好;但如果扫描 100 万行,最后也只保留 10 行,那么扫描范围就可能过大。
因此,建议将 rows 和 filtered 结合起来看。
4.12Extra:额外执行信息
Extra 是非常重要的一列,它会告诉你数据库在普通访问方式之外,还需要进行哪些操作。
常见值如下:
| Extra 值 | 含义 | 排查建议 |
|---|---|---|
Using index | 通常表示覆盖索引 | 通常是有利信号 |
Using where | 需要通过条件进一步过滤 | 本身不代表问题 |
Using index condition | 使用索引条件下推(ICP) | 可能减少回表 |
Using filesort | 需要额外排序 | 检查排序字段和索引 |
Using temporary | 使用临时表处理部分操作 | 检查分组、去重和排序 |
Using index for group-by | 利用索引优化分组或聚合 | 通常是有利信号 |
Using join buffer | 使用连接缓冲区 | 检查 JOIN 条件和索引 |
Impossible WHERE | 优化器判断条件不可能成立 | 检查查询条件 |
Using intersect(...) | 使用多个索引结果的交集 | 结合实际访问计划判断 |
Using union(...) | 使用多个索引结果的并集 | 结合实际访问计划判断 |
这些信息可能组合出现,例如:
Using index condition; Using where
具体显示内容会因 MySQL 版本、查询类型和执行计划而有所不同。
①Using index
例如:
SELECT company_id, status
FROM car_order
WHERE company_id = 1001;
如果索引覆盖了查询需要的字段,就可能出现 Using index。
它通常意味着可以直接从索引中获得所需数据,不需要为了读取其他列再回表。
②Using where
例如:
SELECT *
FROM car_order
WHERE status = 1;
即使数据库使用某个索引,也可能还需要通过 WHERE 条件进一步过滤记录。
Using where 是正常的执行信息,不代表索引失效。
③Using index condition
这通常表示使用了索引条件下推(Index Condition Pushdown,ICP)。
它允许存储引擎利用索引中的字段先判断部分条件,尽可能减少需要回表读取的记录。
例如:
CREATE INDEX idx_company_status
ON car_order (company_id, status);
查询:
SELECT *
FROM car_order
WHERE company_id = 1001
  AND status > 1;
在适合的执行计划下,可能利用索引条件下推减少回表。
④Using filesort
例如:
SELECT *
FROM car_order
WHERE company_id = 1001
ORDER BY amount DESC
LIMIT 20;
如果没有合适的索引支持该排序,MySQL 可能需要执行额外排序,并显示 Using filesort。
可以考虑是否存在合理的索引:
CREATE INDEX idx_company_amount
ON car_order (company_id, amount);
但需要结合实际查询的选择性、返回行数、索引维护成本和排序方向验证。
另外,filesort 是 MySQL 对额外排序过程的术语,不意味着一定发生了磁盘文件排序。数据量较小时,排序可能在内存中完成。
⑤Using temporary
它表示执行计划使用了临时表处理某些操作。
例如:
SELECT status, COUNT(*)
FROM car_order
GROUP BY status
ORDER BY COUNT(*) DESC;
可能因为分组、聚合、排序等操作使用临时表。
看到它时,应该进一步判断:
- 数据量有多大。
- 临时表处理了多少数据。
- 是否存在不必要的排序或分组。
- 索引能否改善过滤或分组效率。
- 实际执行时间是否真的受到影响。
不要仅仅为了消除 Using temporary 就随意增加索引,因为并非所有临时表都能或都值得通过索引消除。
五、把 EXPLAIN 的所有列放在一起分析
前面分别解释了 12 列,接下来用一个完整的案例,把这些字段串起来。
假设订单表已经建立以下索引:
CREATE INDEX idx_company_status_time
ON car_order (company_id, status, create_time);
查询:
EXPLAIN
SELECT id, company_id, status, create_time
FROM car_order
WHERE company_id = 1001
  AND status = 1
  AND create_time >= '2026-10-01'
  AND create_time < '2026-11-01'
ORDER BY create_time DESC
LIMIT 20;
下面是一份用于说明各列含义的模拟执行计划:
| 列名 | 模拟值 |
|---|---|
id | 1 |
select_type | SIMPLE |
table | car_order |
partitions | NULL |
type | range |
possible_keys | idx_company_status_time |
key | idx_company_status_time |
key_len | 14 |
ref | NULL |
rows | 500 |
filtered | 100.00 |
Extra | Using where; Using index |
以上数据是假设的示例,不代表在任何实际数据库中运行都会得到这些值。
5.1 如何解读这个执行计划?
第一步,看 type:
type = range
说明数据库采用索引范围扫描,而不是全表扫描。
第二步,看 key:
key = idx_company_status_time
说明优化器选择了预期的联合索引。
第三步,看 key_len:
key_len = 14
在前面假设的字段定义下,这可能意味着三个索引字段都参与了访问,但还要结合具体字段类型和范围条件确认。
第四步,看 rows:
rows = 500
优化器预计需要检查约 500 行。对于一张有数百万条记录的订单表,这可能是一个合理的扫描规模,但仍然需要与实际返回行数和真实耗时对比。
第五步,看 filtered:
filtered = 100.00
表示优化器预计保留比例为 100%。这并不是说整个表没有过滤,而是针对当前执行计划中该表访问和相关过滤阶段的估算。
第六步,看 Extra:
Using where; Using index
这里可以理解为需要通过条件过滤,并且查询可能被索引覆盖,不需要回表读取完整记录。
整体判断:这个执行计划看起来比较合理,但不能只靠 EXPLAIN 就断定 SQL 一定很快。 还需要看真实执行时间、实际扫描行数、并发和数据分布。
六、EXPLAIN ANALYZE:查看实际执行情况
普通 EXPLAIN 主要展示优化器的估算结果。MySQL 8.0.18 及以上版本提供了 EXPLAIN ANALYZE,可以实际执行查询并
以上就是MySQL慢查询从定位问题到EXPLAIN的排查指南的详细内容,更多关于MySQL慢查询排查指南的资料请关注脚本之家其它相关文章!