
Oracle数据库多表查询实现各种实例
作者:IvanCodes
前言
在实际的数据库应用中,我们很少只查询单个表。通常,所需的信息会分散在多个相互关联的表中。Oracle SQL 提供了强大的多表查询能力,主要通过各种类型的连接 (JOIN) 和子查询 (Subquery) (包括内联视图) 以及特定的分页技巧来实现。
思维导图
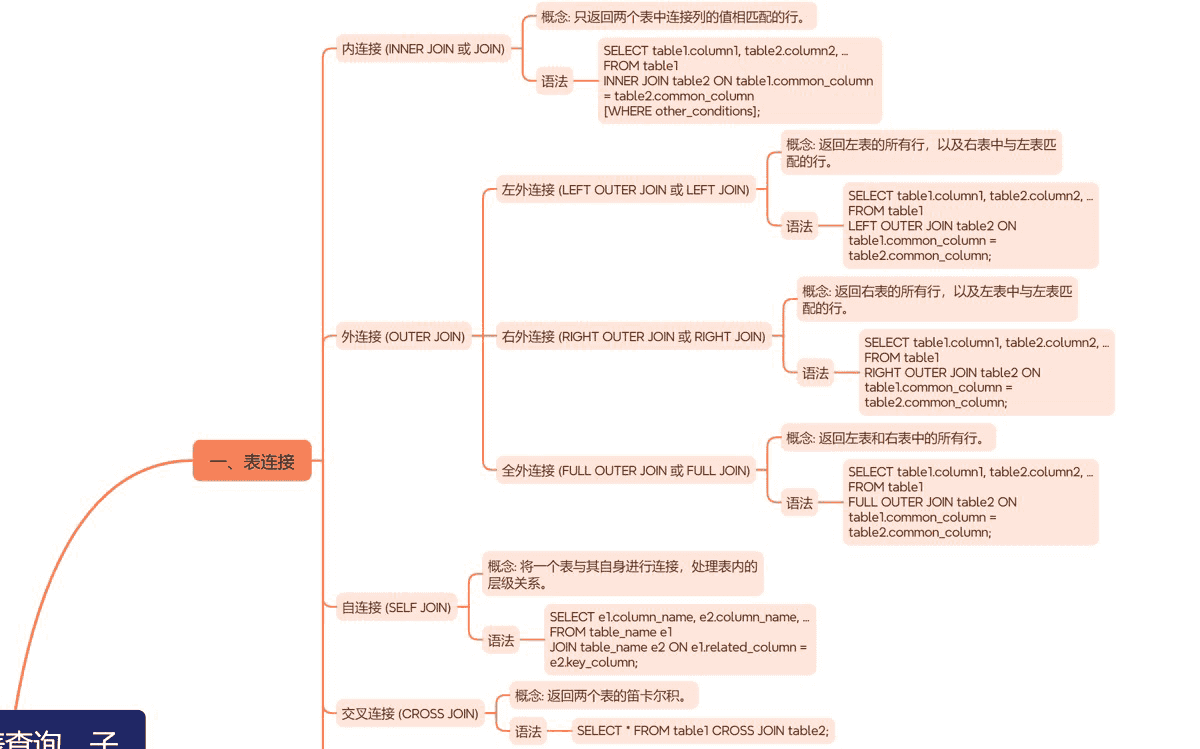
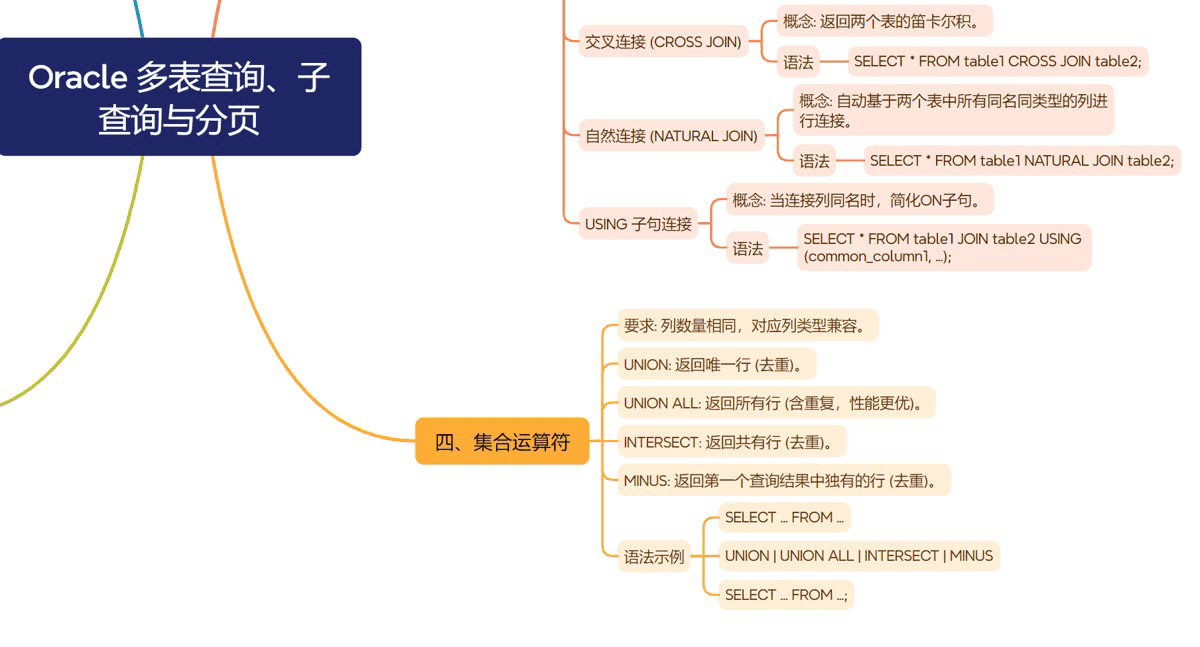
一、表连接
表连接是根据两个或多个表中的共同列 (或满足特定条件的列) 将这些表的行组合起来。
1.1 内连接 (INNER JOIN 或 JOIN)
概念: 只返回两个表中连接列的值相匹配的行。如果某行在一个表中没有在另一个表中找到匹配行,则该行不会出现在结果集中。
语法 (ANSI SQL-92 标准,推荐):
SELECT table1.column1, table2.column2, ...
FROM table1
INNER JOIN table2 ON table1.common_column = table2.common_column
[WHERE other_conditions];
代码案例:
假设有 employees (employee_id, first_name, department_id) 和 departments (department_id, department_name) 表。
查询员工姓名及其所在部门的名称:
SELECT e.first_name, d.department_name
FROM employees e
INNER JOIN departments d ON e.department_id = d.department_id;
1.2 外连接 (OUTER JOIN)
外连接除了返回满足连接条件的匹配行外,还会返回一个表中没有匹配到另一个表的行。
- 左外连接 (LEFT OUTER JOIN 或 LEFT JOIN)
概念: 返回左表 (FROM子句中先列出的表) 的所有行,以及右表中与左表匹配的行。如果右表中没有匹配行,则右表的列显示为 NULL。
语法 (ANSI):
SELECT table1.column1, table2.column2, ...
FROM table1
LEFT OUTER JOIN table2 ON table1.common_column = table2.common_column;
代码案例: 查询所有员工及其部门名称,即使某些员工没有分配部门。
SELECT e.first_name, d.department_name
FROM employees e
LEFT JOIN departments d ON e.department_id = d.department_id;
- 右外连接 (RIGHT OUTER JOIN 或 RIGHT JOIN)
概念: 返回右表 (JOIN子句后列出的表) 的所有行,以及左表中与右表匹配的行。如果左表中没有匹配行,则左表的列显示为 NULL。
语法 (ANSI):
SELECT table1.column1, table2.column2, ...
FROM table1
RIGHT OUTER JOIN table2 ON table1.common_column = table2.common_column;
代码案例: 查询所有部门及其员工 (如果有),即使某些部门没有员工。
SELECT d.department_name, e.first_name
FROM employees e
RIGHT JOIN departments d ON e.department_id = d.department_id;
- 全外连接 (FULL OUTER JOIN 或 FULL JOIN)
概念: 返回左表和右表中的所有行。如果某行在一个表中没有匹配到另一个表,则对方表的列显示为 NULL。
语法 (ANSI):
SELECT table1.column1, table2.column2, ...
FROM table1
FULL OUTER JOIN table2 ON table1.common_column = table2.common_column;
代码案例: 查询所有员工和所有部门,显示匹配关系。
SELECT e.first_name, d.department_name
FROM employees e
FULL OUTER JOIN departments d ON e.department_id = d.department_id;
1.3 自连接
概念: 将一个表与其自身进行连接,就好像是两个独立的表一样。通常用于比较表中不同行之间的数据,或处理表内的层级关系 (如员工与经理)。
语法: 必须为同一个表使用不同的别名。
SELECT e1.column_name, e2.column_name, ...
FROM table_name e1
JOIN table_name e2 ON e1.related_column = e2.key_column;
代码案例: 假设 employees 表有 employee_id 和 manager_id 列。查询每个员工及其经理的姓名。
SELECT emp.first_name AS "Employee Name", mgr.first_name AS "Manager Name"
FROM employees emp
JOIN employees mgr ON emp.manager_id = mgr.employee_id;
1.4 交叉连接 (CROSS JOIN 或 CARTESIAN PRODUCT)
概念: 返回第一个表的每一行与第二个表的每一行的所有可能组合 (笛卡尔积)。
语法 (ANSI):
SELECT *
FROM table1
CROSS JOIN table2;
1.5 自然连接 (NATURAL JOIN)
概念: Oracle 会自动查找两个表中所有名称和数据类型都相同的列,并基于这些列进行等值连接。
语法:
SELECT *
FROM table1
NATURAL JOIN table2;
警告: 不推荐广泛使用,因其隐式依赖列名。
1.6 USING 子句连接
概念: 当连接的列在两个表中名称相同时,可以使用 USING 子句简化连接条件。
语法:
SELECT *
FROM table1
JOIN table2 USING (common_column1, common_column2, ...);
代码案例:
SELECT e.first_name, d.department_name, department_id
FROM employees e
JOIN departments d USING (department_id);
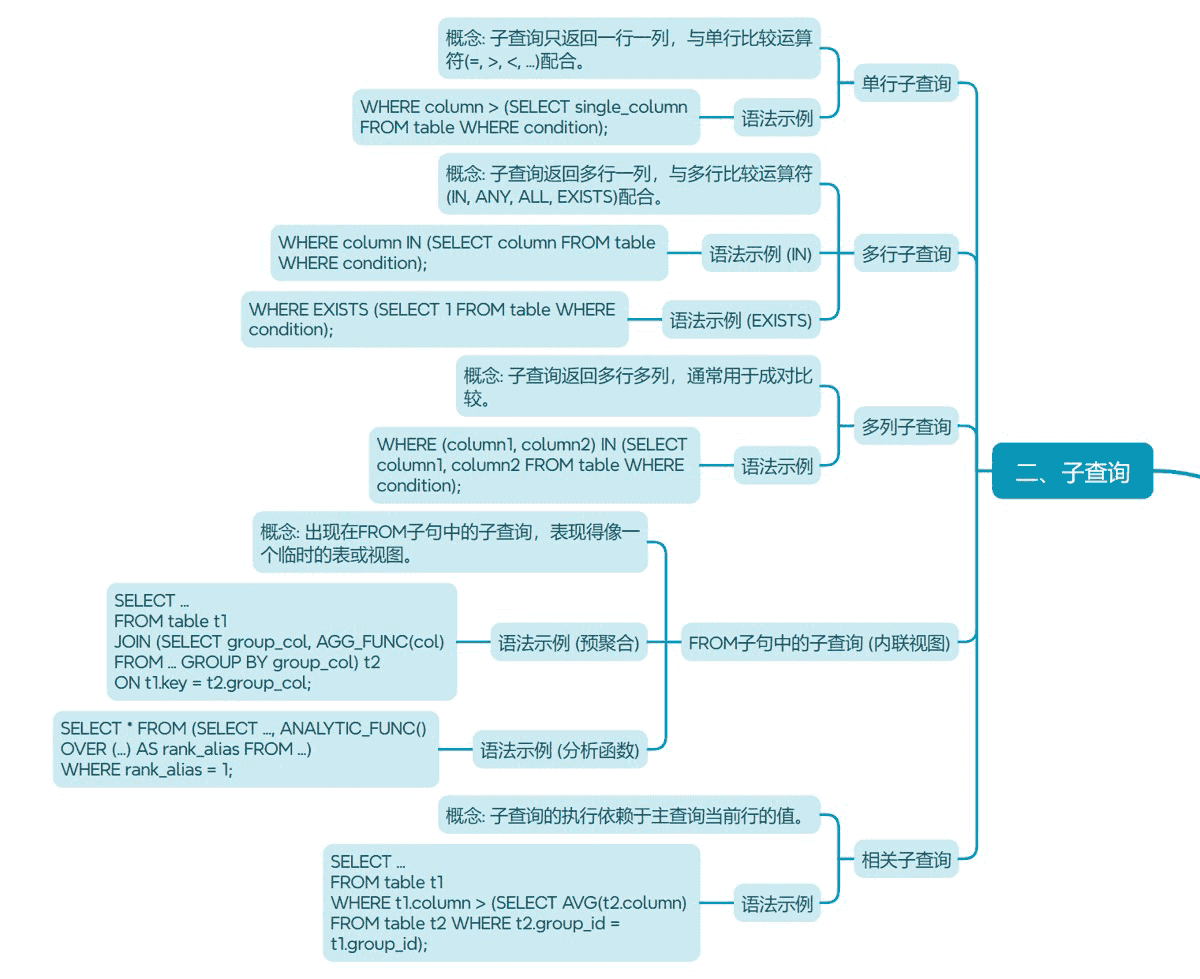
二、子查询
子查询是嵌套在另一个SQL语句 (主查询) 内部的 SELECT 语句。
2.1 单行子查询
概念: 子查询只返回一行一列的结果。可以与单行比较运算符 (=, >, <, >=, <=, <>) 一起使用。
代码案例: 查询薪水高于员工 ‘Abel’ 的所有员工。
SELECT first_name, salary
FROM employees
WHERE salary > (SELECT salary FROM employees WHERE last_name = 'Abel');
2.2 多行子查询
概念: 子查询返回多行一列的结果。需要与多行比较运算符 (IN, ANY, ALL, EXISTS) 一起使用。
代码案例:
查询与部门10或20中任何一个员工薪水相同的员工:
SELECT first_name, salary
FROM employees
WHERE salary IN (SELECT salary FROM employees WHERE department_id IN (10, 20));
查询有下属员工的经理 (使用 EXISTS):
SELECT e.employee_id, e.first_name
FROM employees e
WHERE EXISTS (SELECT 1 FROM employees WHERE manager_id = e.employee_id);
2.3 多列子查询
概念: 子查询返回多行多列的结果。通常用于成对比较。
代码案例: 查询与 ‘Steven King’ 部门相同且职位也相同的其他员工。
SELECT first_name, last_name, department_id, job_id
FROM employees
WHERE (department_id, job_id) IN (SELECT department_id, job_id
                                   FROM employees
                                   WHERE first_name = 'Steven' AND last_name = 'King')
AND NOT (first_name = 'Steven' AND last_name = 'King');
2.4 FROM子句中的子查询 (内联视图)
概念: 当子查询出现在 FROM 子句中时,它表现得像一个临时的表或视图。主查询可以从这个内联视图中选择数据、进行连接等操作。内联视图必须要有别名。
用途:
- 简化复杂查询:将复杂逻辑步骤封装,使主查询清晰。
- 预先聚合或排序:内联视图中完成计算,主查询基于此结果操作。
- 克服SQL限制:如窗口函数结果的后续过滤。
代码案例1:查询每个部门的平均薪水及部门名称
SELECT d.department_name, dept_sal_stats.avg_salary, dept_sal_stats.emp_count
FROM departments d
JOIN (SELECT department_id, AVG(salary) AS avg_salary, COUNT(*) AS emp_count
      FROM employees
      GROUP BY department_id) dept_sal_stats
ON d.department_id = dept_sal_stats.department_id;
- 解析: 内联视图 dept_sal_stats 计算部门统计信息,主查询连接获取部门名。
代码案例2:查找每个部门中薪水最高的员工
SELECT emp_ranked.first_name, emp_ranked.last_name, emp_ranked.salary, emp_ranked.department_name
FROM (SELECT e.first_name, e.last_name, e.salary, d.department_name,
             RANK() OVER (PARTITION BY e.department_id ORDER BY e.salary DESC) as salary_rank
      FROM employees e
      JOIN departments d ON e.department_id = d.department_id) emp_ranked
WHERE emp_ranked.salary_rank = 1;
- 解析: 内联视图 emp_ranked 使用分析函数排名,外层查询筛选排名第一的。
2.5 相关子查询
概念: 子查询的执行依赖于主查询当前行的值。
代码案例: 查询薪水高于其所在部门平均薪水的员工。
SELECT e1.first_name, e1.salary, e1.department_id
FROM employees e1
WHERE e1.salary > (SELECT AVG(e2.salary)
                   FROM employees e2
                   WHERE e2.department_id = e1.department_id);
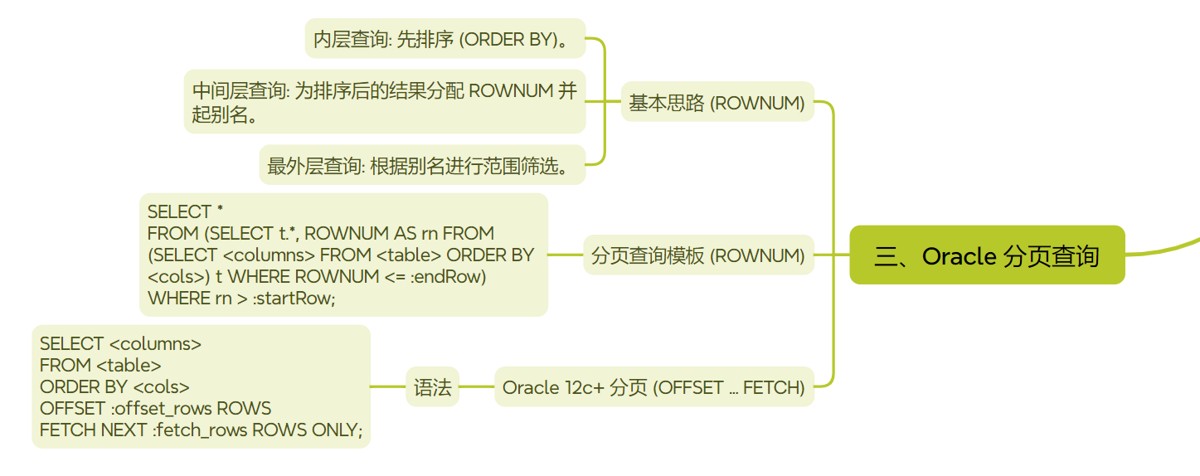
三、Oracle 分页查询
在Oracle中,实现分页通常依赖于伪列 ROWNUM 和内联视图的巧妙结合。因为 ROWNUM 是在结果集生成之后、ORDER BY 应用之前分配的,所以直接在 WHERE 中使用 ROWNUM > n 是无效的。
基本思路:
- 内层查询:先对需要的数据进行排序 (ORDER BY)。
- 中间层查询 (内联视图):为排序后的结果集分配 ROWNUM,并给这个 ROWNUM 列一个别名 (例如 rn)。
- 最外层查询:根据别名 rn 进行范围筛选,实现分页。
分页查询模板 (假设每页显示 pageSize 条,查询第 pageNumber 页):
SELECT *
FROM (SELECT t.*, ROWNUM AS rn
      FROM (SELECT <column_list_or_*>
            FROM <your_table_or_join_clauses>
            [WHERE <your_filter_conditions>]
            ORDER BY <your_sorting_columns>) t
      WHERE ROWNUM <= (:pageNumber * :pageSize)) -- :pageNumber 和 :pageSize 是占位符
WHERE rn > ((:pageNumber - 1) * :pageSize);
- :pageNumber: 当前页码 (从1开始)。
- :pageSize: 每页显示的记录数。
代码案例:查询员工表,按薪水降序,每页显示10条,获取第2页数据
(pageSize = 10, pageNumber = 2)
SELECT employee_id, first_name, last_name, salary
FROM (SELECT employee_id, first_name, last_name, salary, ROWNUM AS rn
      FROM (SELECT employee_id, first_name, last_name, salary
            FROM employees
            ORDER BY salary DESC)
      WHERE ROWNUM <= (2 * 10))
WHERE rn > ((2 - 1) * 10);
Oracle 12c 及以上版本的分页 (使用 OFFSET ... FETCH NEXT ... ROWS ONLY)
Oracle 12c 引入了更简洁的分页语法。
SELECT <column_list_or_*>
FROM <your_table_or_join_clauses>
[WHERE <your_filter_conditions>]
ORDER BY <your_sorting_columns>
OFFSET (:pageNumber - 1) * :pageSize ROWS
FETCH NEXT :pageSize ROWS ONLY;
代码案例 (12c+):查询员工表,按薪水降序,每页10条,获取第2页
SELECT employee_id, first_name, last_name, salary
FROM employees
ORDER BY salary DESC
OFFSET (2 - 1) * 10 ROWS
FETCH NEXT 10 ROWS ONLY;
四、集合运算符
集合运算符用于合并两个或多个 SELECT 语句的结果集。
要求: 列数量相同,对应列类型兼容。
- UNION: 返回唯一行 (去重)。
- UNION ALL: 返回所有行 (含重复,性能更优)。
- INTERSECT: 返回共有行 (去重)。
- MINUS: 返回第一个查询结果中独有的行 (去重)。
代码案例:
SELECT employee_id, first_name FROM employees WHERE department_id = 10
UNION ALL
SELECT employee_id, first_name FROM employees WHERE department_id = 20;
总结: 多表查询是关系型数据库的核心功能。熟练运用各种JOIN类型、灵活使用子查询 (特别是内联视图),以及掌握分页技巧和集合运算符,对于构建复杂、高效的SQL查询至关重要。
练习题
背景表:
CREATE TABLE regions (
    region_id NUMBER PRIMARY KEY,
    region_name VARCHAR2(25)
);

CREATE TABLE countries (
    country_id CHAR(2) PRIMARY KEY,
    country_name VARCHAR2(40),
    region_id NUMBER
);

CREATE TABLE locations (
    location_id NUMBER PRIMARY KEY,
    street_address VARCHAR2(40),
    postal_code VARCHAR2(12),
    city VARCHAR2(30),
    state_province VARCHAR2(25),
    country_id CHAR(2)
);

CREATE TABLE jobs (
    job_id VARCHAR2(10) PRIMARY KEY,
    job_title VARCHAR2(35),
    min_salary NUMBER(6),
    max_salary NUMBER(6)
);

CREATE TABLE departments (
    department_id NUMBER PRIMARY KEY,
    department_name VARCHAR2(30),
    manager_id NUMBER,
    location_id NUMBER
);

CREATE TABLE employees (
    employee_id NUMBER PRIMARY KEY,
    first_name VARCHAR2(50),
    last_name VARCHAR2(50),
    email VARCHAR2(100),
    phone_number VARCHAR2(20),
    hire_date DATE,
    job_id VARCHAR2(10),
    salary NUMBER(8,2),
    commission_pct NUMBER(2,2),
    manager_id NUMBER,
    department_id NUMBER
);

CREATE TABLE job_history (
    employee_id NUMBER,
    start_date DATE,
    end_date DATE,
    job_id VARCHAR2(10),
    department_id NUMBER,
    PRIMARY KEY (employee_id, start_date)
);
题目:
- 查询所有员工的姓名 (first_name, last_name) 及其所在部门的名称 (department_name)。
- 查询所有部门的名称 (department_name) 以及该部门经理的姓名 (first_name, last_name)。(提示:departments.manager_id 对应 employees.employee_id)
- 查询所有员工的姓名、职位名称 (job_title) 和薪水 (salary)。
- 查询所有在 ‘Seattle’ (city) 工作的员工的姓名和部门名称。
- 查询所有员工的姓名、部门名称和其所在部门的城市 (city)。
- 查询所有员工的姓名及其直接上级经理的姓名。如果员工没有经理,经理姓名显示为NULL。
- 查询每个部门的名称以及在该部门工作的员工数量。只显示员工数量大于5的部门。
- 查询所有国家名称 (country_name) 以及这些国家所属的区域名称 (region_name)。
- 查询所有曾经换过工作 (即在 job_history 表中有记录) 的员工的姓名 (使用 EXISTS 或 IN 子查询)。
- 使用内联视图,查询每个部门的ID、部门名称以及该部门的最高薪水。
- 查询员工表中,按 hire_date 最新入职排序,获取第6到第10名员工的 employee_id, first_name, hire_date。(使用 ROWNUM 方法)
- (Oracle 12c+) 查询员工表中,按 salary 从高到低排序,获取第11到第15名员工的 employee_id, first_name, salary。(使用 OFFSET FETCH 方法)
- 使用内联视图,找出那些部门平均薪水高于公司总平均薪水的部门ID和部门平均薪水。
- 查询每个员工的姓名、薪水,以及其所在部门的平均薪水 (使用相关子查询或内联视图与JOIN)。
- 使用集合运算符 MINUS,找出那些存在于 departments 表中但当前没有任何员工的部门的 department_id 和 department_name。
答案与解析:
- 员工姓名及部门名称:
SELECT e.first_name, e.last_name, d.department_name
FROM employees e
JOIN departments d ON e.department_id = d.department_id;
- 解析: 使用 INNER JOIN (或 JOIN) 连接 employees 和 departments 表,基于 department_id。
- 部门名称及部门经理姓名:
SELECT d.department_name, mgr.first_name AS manager_first_name, mgr.last_name AS manager_last_name
FROM departments d
LEFT JOIN employees mgr ON d.manager_id = mgr.employee_id;
- 解析: departments 表通过 manager_id 自连接到 employees 表 (别名为 mgr)。使用 LEFT JOIN 是为了即使某个部门没有指定经理 (或经理ID无效),部门名称仍然会显示。
- 员工姓名、职位名称和薪水:
SELECT e.first_name, e.last_name, j.job_title, e.salary
FROM employees e
JOIN jobs j ON e.job_id = j.job_id;
- 解析: INNER JOIN 连接 employees 和 jobs 表。
- 在’Seattle’工作的员工姓名和部门名称:
SELECT e.first_name, e.last_name, d.department_name
FROM employees e
JOIN departments d ON e.department_id = d.department_id
JOIN locations l ON d.location_id = l.location_id
WHERE l.city = 'Seattle';
- 解析: 三表连接:employees -> departments -> locations。WHERE子句过滤城市。
- 员工姓名、部门名称和部门所在城市:
SELECT e.first_name, e.last_name, d.department_name, l.city
FROM employees e
JOIN departments d ON e.department_id = d.department_id
LEFT JOIN locations l ON d.location_id = l.location_id;
- 解析: 使用 LEFT JOIN 连接 locations 是为了确保即使某个部门的 location_id 为空或无效,员工和部门信息仍然显示。
- 员工姓名及其经理姓名:
SELECT emp.first_name || ' ' || emp.last_name AS "Employee Name",
       mgr.first_name || ' ' || mgr.last_name AS "Manager Name"
FROM employees emp
LEFT JOIN employees mgr ON emp.manager_id = mgr.employee_id;
- 解析: 自连接 employees 表。LEFT JOIN 确保即使员工没有经理 (如最高层领导),员工信息也会显示,其经理姓名部分为NULL。
- 各部门员工数 (大于5):
SELECT d.department_name, COUNT(e.employee_id) AS num_employees
FROM departments d
JOIN employees e ON d.department_id = e.department_id
GROUP BY d.department_name
HAVING COUNT(e.employee_id) > 5;
- 解析: 先连接两表,然后按部门名称分组并计数,最后用 HAVING 过滤员工数大于5的部门。
- 国家名称及其区域名称:
SELECT c.country_name, r.region_name
FROM countries c
JOIN regions r ON c.region_id = r.region_id;
- 解析: 简单的两表内连接。
- 换过工作的员工姓名:
方法一 (使用 DISTINCT 和 JOIN):
SELECT DISTINCT e.first_name, e.last_name
FROM employees e
JOIN job_history jh ON e.employee_id = jh.employee_id;
方法二 (使用 EXISTS 子查询):
SELECT e.first_name, e.last_name
FROM employees e
WHERE EXISTS (SELECT 1 FROM job_history jh WHERE jh.employee_id = e.employee_id);
- 解析: 检查员工ID是否存在于 job_history 表中。
- 使用内联视图查询各部门最高薪水:
SELECT d.department_id, d.department_name, dept_max_sal.max_salary
FROM departments d
JOIN (SELECT department_id, MAX(salary) AS max_salary
      FROM employees
      WHERE department_id IS NOT NULL
      GROUP BY department_id) dept_max_sal
ON d.department_id = dept_max_sal.department_id;
- 解析: 内联视图 dept_max_sal 计算了每个部门的最高薪水。然后主查询将其与 departments 表连接。
- 分页查询 (ROWNUM方法,按入职日期最新,第6-10名):
SELECT employee_id, first_name, hire_date
FROM (SELECT employee_id, first_name, hire_date, ROWNUM AS rn
      FROM (SELECT employee_id, first_name, hire_date
            FROM employees
            ORDER BY hire_date DESC)
      WHERE ROWNUM <= 10)
WHERE rn >= 6;
- 解析: 内层先按 hire_date 降序排,中间层取前10条并编号,最外层筛选编号6到10。
- 分页查询 (OFFSET FETCH方法,按薪水降序,第11-15名):
SELECT employee_id, first_name, salary
FROM employees
ORDER BY salary DESC
OFFSET 10 ROWS FETCH NEXT 5 ROWS ONLY;
- 解析: OFFSET 10 ROWS 跳过前10条记录,FETCH NEXT 5 ROWS ONLY 取接下来的5条。
- 部门平均薪水高于公司总平均薪水的部门:
SELECT dept_avg.department_id, dept_avg.avg_dept_salary
FROM (SELECT department_id, AVG(salary) AS avg_dept_salary
      FROM employees
      WHERE department_id IS NOT NULL
      GROUP BY department_id) dept_avg
WHERE dept_avg.avg_dept_salary > (SELECT AVG(salary) FROM employees);
- 解析: 内联视图 dept_avg 计算每个部门的平均薪水。主查询的 WHERE 子句中的子查询计算公司的总平均薪水,然后进行比较。
- 员工薪水及其部门平均薪水:
方法一 (相关子查询):
SELECT e.first_name, e.salary,
       (SELECT AVG(salary) FROM employees WHERE department_id = e.department_id) AS department_avg_salary
FROM employees e;
方法二 (内联视图与JOIN):
SELECT e.first_name, e.salary, dept_avg.avg_salary AS department_avg_salary
FROM employees e
LEFT JOIN (SELECT department_id, AVG(salary) AS avg_salary
           FROM employees
           GROUP BY department_id) dept_avg
ON e.department_id = dept_avg.department_id;
- 解析: 两种方法都可以实现。相关子查询对每一行外层查询都会执行一次子查询。内联视图先计算好所有部门的平均薪水,然后连接。通常内联视图+JOIN的性能会更好,尤其对于大表。
- 使用MINUS找出没有员工的部门:
SELECT department_id, department_name FROM departments
MINUS
SELECT DISTINCT d.department_id, d.department_name
FROM departments d
JOIN employees e ON d.department_id = e.department_id;
- 解析: 第一个 SELECT 列出所有部门。第二个 SELECT 列出所有有员工的部门 (通过与 employees 表连接得到)。MINUS 运算符返回只在第一个结果集中的部门,即没有员工的部门。
总结
到此这篇关于Oracle数据库多表查询实现各种实例的文章就介绍到这了,更多相关Oracle多表查询内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!