
mysql表操作与查询功能详解
作者:QQ_437664314
本文系统讲解MySQL表操作与查询,涵盖创建、修改、复制表语法,基本查询结构及WHERE、GROUP BY等子句,本文结合实例代码给大家介绍的非常详细,感兴趣的朋友跟随小编一起看看吧
01.表的操作
1.1表操作概览
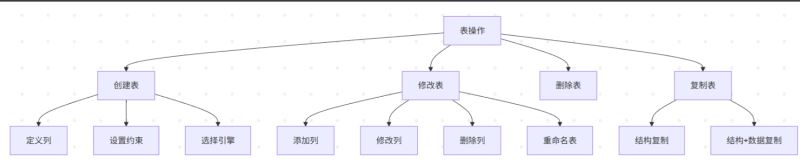
1.2创建表
语法: 语句以;结尾。
#  []表示里面内容可选,使用时不带[]本身
CREATE TABLE [IF NOT EXISTS] table_name (
    column1 datatype [constraints],
    column2 datatype [constraints],
    ...
    [table_constraints]
) [ENGINE=storage_engine] [DEFAULT CHARSET=charset];
数据类型:
- 数值类型:INT、BIGINT、FLOAT、DOUBLE、DECIMAL(10,2)
- 字符串类型:VARCHAR(255)、TEXT、CHAR(10)
- 日期时间:DATE、TIME、DATETIME、TIMESTAMP
- 其他类型:
- BOOLEAN
- ENUM (’
opt1’,’opt2’)只能存储定义时指定的值之一,单选 - SET (’
opt1’,’opt2’,’opt3’),多选
列约束:
- NOT NULL`:该字段不能为空
UNIQUE:该字段值必须唯一DEFAULT:设置默认值AUTO_INCREMENT:自增主键(通常用于 ID 字段)
表约束: 主外键
PRIMARY KEY (列1, ...),
FOREIGN KEY (字段名) REFERENCES 主表(列),
创建主表: 主键时表的身份证,唯一,可由多个字段组成。
create table myclass(
	id int primary key,
	name varchar(30)not null comment'班级名'
);
创建从表: 外键是与其他表的关系纽带。
create table stu(
	id int primary key,
	name varchar(30) not nu1l comment'学生名',
    class_id int ,
	foreign key(class_id) references myclass(id)
	);   #插入数据过程省略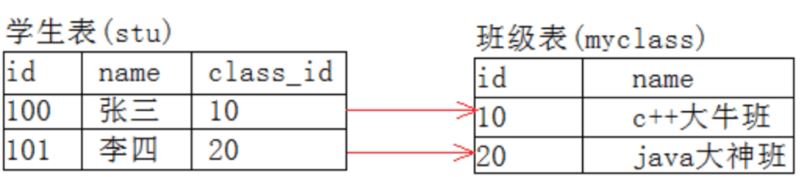
创建表代码示例:
-- 1:创建数据库
CREATE DATABASE sql_stu;
-- 2:使用数据库
USE sql_stu;
-- 3:创建表
CREATE TABLE IF NOT EXISTS table_stu (
    id INT PRIMARY KEY AUTO_INCREMENT,
    username VARCHAR(50) NOT NULL UNIQUE,
    age INT DEFAULT 18,
    create_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
-- 使用 DESCRIBE 表名 或 SHOW CREATE TABLE 表名 查看表
DESCRIBE table_name;-- 或简写为:DESC table_name;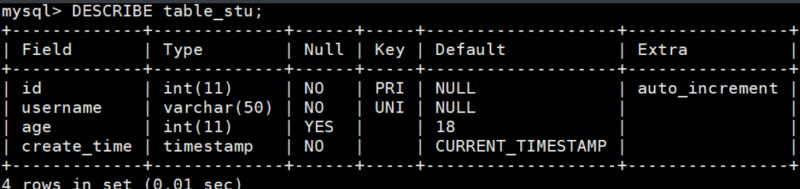
1.3修改表
语法:
ALTER TABLE 表名
    操作1,
    ...;
修改表的操作:
ALTER TABLE employees
#添加列
ADD COLUMN 列名 数据类型 AFTER 某个列;
#修改列数据类型与重命名
MODIFY COLUMN 列名 数据类型;
CHANGE COLUMN 老列名 新列名 数据类型;
#删除列
DROP COLUMN 列名;
#添加约束
ADD PRIMARY KEY (emp_id);
---
外键?
#删约束
DROP FOREIGN KEY 外键名;
DROP PRIMARY KEY;
1.4复制表
#仅复制结构
CREATE TABLE 新表 LIKE 源表;
#复制结构+数据
CREATE TABLE 新表 AS
SELECT * FROM 源表;
#选择复制结构+数据
CREATE TABLE 新表 AS
SELECT 列1,列2,列3
FROM 源表
WHERE 条件;
-- 创建表
CREATE TABLE stuinfo (
    stuid INT PRIMARY KEY,
    stuname VARCHAR(20) UNIQUE NOT NULL,
    stugender CHAR(1) DEFAULT '男',
    email VARCHAR(20) NOT NULL,
    age INT,
    majorid INT,
    CONSTRAINT fk_stuinfo_major FOREIGN KEY (majorid) REFERENCES major(id)
);
-- 修改表结构
ALTER TABLE stuinfo RENAME TO stuinfo1;  -- 重命名表
ALTER TABLE stuinfo1 ADD COLUMN borndate TIMESTAMP NOT NULL;  -- 添加列
ALTER TABLE stuinfo1 CHANGE COLUMN borndate birthday DATETIME;  -- 修改列名
ALTER TABLE stuinfo1 MODIFY COLUMN birthday DATE;  -- 修改数据类型
ALTER TABLE stuinfo1 DROP COLUMN age;  -- 删除列
-- 复制表
CREATE TABLE newTable LIKE stuinfo;  -- 仅复制结构
CREATE TABLE emp_copy SELECT * FROM employees;  -- 复制结构和数据
02.基本查询操作
基础结构:
SELECT [DISTINCT] 列1, 列2, ...  --选择需要显示的列
FROM 表名    				     --首先确定数据来源
[WHERE 条件]     	 		      --对原始数据进行筛选
[GROUP BY 分组列]   			 --对筛选后的数据分组
[HAVING 分组条件]   		    --对分组后的数据进行筛选
[ORDER BY 排序列 [ASC|DESC]]     --对结果进行排序
[LIMIT [偏移量,] 行数];          --限制返回结果数量
执行顺序 :FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT
2.1 SELECT选择列
-- 查询所有列
SELECT * FROM users;
-- 查询指定列
SELECT id, ... FROM users;
-- 列别名
SELECT id AS user_id, username AS name FROM users;--(AS可省略)
-- 去重查询(DISTINCT)
SELECT DISTINCT country FROM customers;
-- 连接字段 CONCAT
SELECT CONCAT(last_name, first_name) AS 姓名 FROM employees;
2.2 FROM指定表
-- 单表查询
SELECT * FROM products;
-- 多表连接查询(内连接)
SELECT *
FROM orders
INNER JOIN users ON orders.user_id = users.id;
SELECT IFNULL(commission_pct, 0.00) AS 奖金, commission_pct
FROM employees;
2.3 WHERE条件过滤
–> 在分组前过滤行
2.3.1 基本条件表达式
/* 语法结构:
   SELECT 查询列表
   FROM 表名
   WHERE 筛选条件   */
-- 比较运算符:> < = != <> >= <=
SELECT * FROM employees WHERE salary > 12000;
-- 逻辑运算符:AND OR NOT
SELECT last_name, salary
FROM employees
WHERE salary >= 10000 AND salary <= 20000;
-- 范围查询 BETWEEN AND,或者使用 salary > 10000 AND salary < 20000
SELECT *
FROM employees
WHERE salary BETWEEN 10000 AND 20000;
2.3.2 特殊条件查询
-- IN 查询,IN ()任意一个返回TRUE(1)
SELECT last_name, job_id
FROM employees
WHERE job_id IN ('AD_PRES', 'IT_PROG', 'PU_CLERK');
-- 是 NULL 值判断
SELECT last_name, commission_pct
FROM employees
WHERE commission_pct IS NULL;  -- IS NOT NULL
-- 安全等于 <=> (可判断NULL和普通值)
SELECT last_name, commission_pct
FROM employees
WHERE commission_pct <=> NULL;
2.3.3 模糊查询 LIKE
使用% 匹配任意个字符, _ 匹配单个字符,使用 \ 转义。
-- 基本通配符:% 匹配任意个字符, _ 匹配单个字符
SELECT last_name
FROM employees
WHERE last_name LIKE '_a_%' ESCAPE 'a';  -- 第二个字符为_
-- 使用 \ 转义
...同上
WHERE last_name LIKE '_\_%';  -- 使用 \ 转义
2.4 GROUP BY分组
-- 统计每个部门的员工数
SELECT department, COUNT(*) AS employee_count
FROM employees
GROUP BY department;
-- 分组后过滤(HAVING)
SELECT category, AVG(price) AS avg_price
FROM products
GROUP BY category
HAVING avg_price > 200;  -- 只返回平均价格>200的分组
2.5 ORDER BY排序
-- 基本排序
SELECT * FROM employees ORDER BY salary DESC;  --ASC 升序(默认), DESC (drop降序)
-- 多字段排序
SELECT *
FROM employees
ORDER BY salary DESC, employee_id ASC;
-- 按表达式和函数结果多字段排序
SELECT
    LENGTH(last_name)  字符长度,
    salary * 12 * (1 + IFNULL(commission_pct, 0))  年薪
FROM employees
ORDER BY 年薪 DESC, 字符长度 DESC;  -- 按年薪和字符长度排序
2.6 HAVING 分组后过滤
–> 分组后过滤组
SELECT department, AVG(salary) AS avg_salary
FROM employees
GROUP BY department
HAVING AVG(salary) > 6000;
2.7 LIMIT分页
-- 提取第2页,每页10条           偏移量 每页行数
 SELECT  *  FROM  products LIMIT 10  ,  10;  -- 等价于 OFFSET 10 LIMIT 10
-- 带排序的分页
SELECT *
FROM employees
ORDER BY salary DESC
LIMIT 20, 10;  -- 第3页
03. 函数
3.1 聚合函数
| 函数 | 描述 |
|---|---|
SUM(expr) | 求和 |
AVG(expr) | 平均值 |
MAX(expr) | 最大值 |
MIN(expr) | 最小值 |
COUNT(expr) | 计数 |
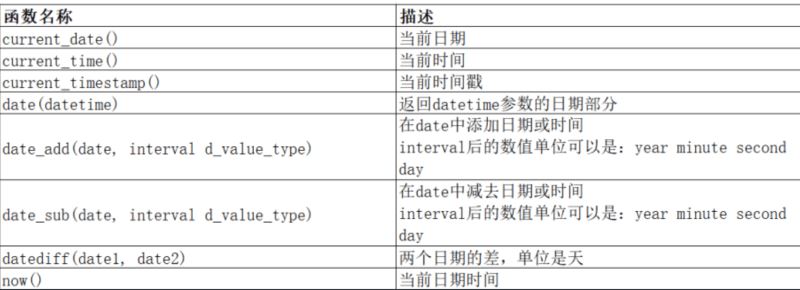
3.2 日期函数
SQL 标准函数
3.3 字符串函数
| 语法 | 功能描述 |
|---|---|
CHARSET(str) | 返回字符串的字符集 |
CONCAT(str1, str2, ...) | 连接多个字符串 |
INSTR(str, substr) | 返回子串在字符串中的位置(从1开始),未找到返回0 |
UCASE(str) 或 UPPER(str) | 串转换为大写 |
LCASE(str) 或 LOWER(str) | 串转换为小写 |
LEFT(str, length) | 从字符串左侧截取指定长度的子串 |
LENGTH(str) | 返回字符串的字节长度(非字符数) |
REPLACE(str, from_str, to_str) | 替换字符串中的指定子串 |
STRCMP(str1, str2) | 逐字符比较两字符串大小(返回-1,0,1) |
SUBSTRING(str, pos, len) | 从指定位置截取子串(pos从1开始) |
TRIM(str) LTRIM(str) RTRIM(str) | 去除字符串前或后面空格 |
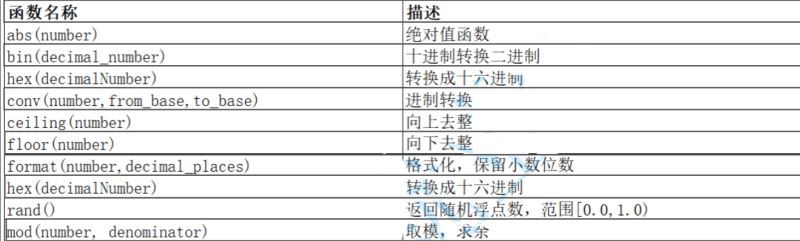
3.4 数学函数
04.复合查询
笛卡尔积: 将两个表穷举的结果
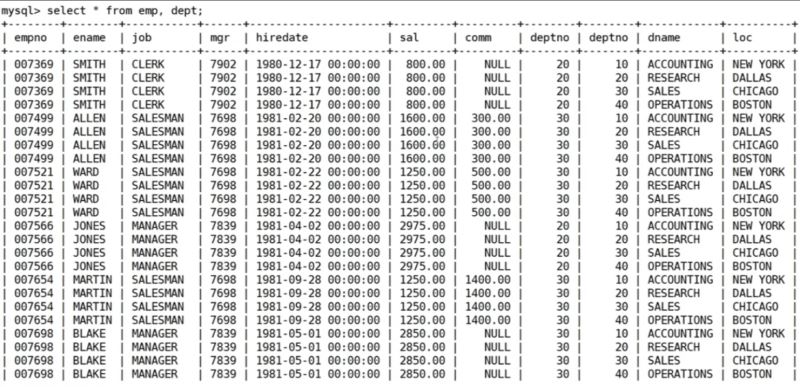
4.1 多表查询
单行子查询是指子查询只返回单列,单行数据;多行子查询是指返回单列多行数据,都是针对单列而言的,而多列子查询则是指查询返回多个列数据的子查询语句。
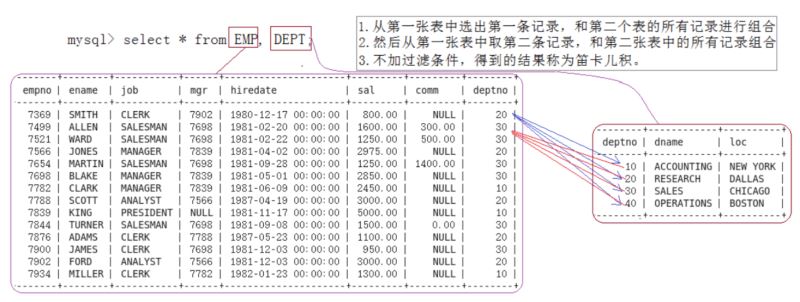
通过将两个表直接笛卡尔积组成一个新表,但是引入了许多无关数据,这时对其进行去除不正确数据后再筛选即可得到
显示部门号为10的部门名,员工名和工资
select ename, sal,dname from EMP, DEPT where EMP.deptno=DEPT.deptno andDEPT.deptno = 10;
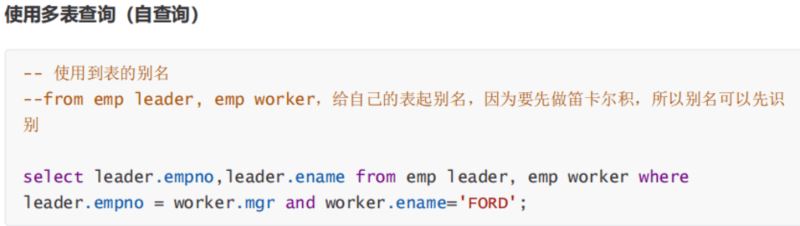
4.2 自连接
自连接是指在同一张表连接查询
4.3 子查询
子查询是指嵌入在其他sql语句中的select语句,也叫嵌套查询。
4.3.1 单行子查询
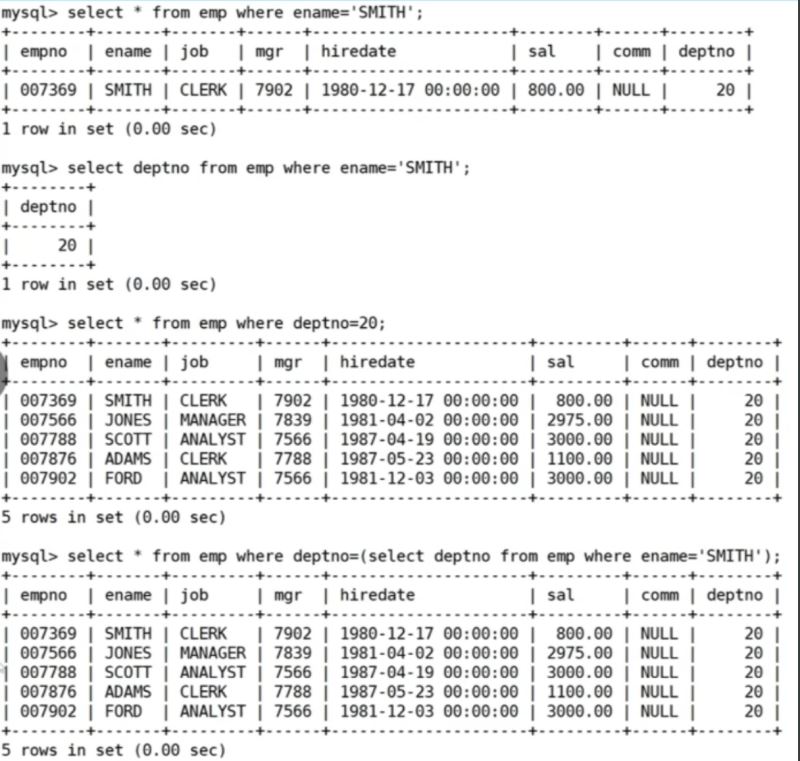
案例: 查询和SMITH的部门和岗位完全相同的所有雇员。下面这个案例返回了多行,视情况而定
4.3.2 多行子查询
- IN/NOT IN 检查值是否在于子查询结果中
- ANY 与子查询返回的任一值比较
- ALL 与子查询返回的所有值比较
- EXISTS 检查存在性
示例:
SELECT *
FROM products
WHERE (category, price) IN (SELECT category, price FROM products WHERE category = 'Electronics');
4.3.3 FROM子句子查询
-- from子查询 (返回临时表)
SELECT dep_ag.department_id, dep_ag.ag, j.grade_level
FROM (
    SELECT AVG(salary) ag, department_id
    FROM employees
    GROUP BY department_id
) AS dep_ag
INNER JOIN job_grades j ON dep_ag.ag BETWEEN j.lowest_sal AND j.highest_sal;
4.3.4 合并查询
联合查询 :
- UNION :并集<-- 该操作符用于取得两个结果集的并集。当使用该操作符时,会自动去掉结果集中的重复行。
- UNION ALL :该操作符用于取得两个结果集的并集。当使用该操作符时,不会去掉结果集中的重复行。
-- 基本联合
SELECT employee_id FROM employees WHERE salary > 15000
UNION
SELECT employee_id FROM employees WHERE commission_pct > 0.2;
-- UNION ALL (保留重复记录)
SELECT department_id FROM employees
UNION ALL
SELECT department_id FROM departments;
05. 内外连接
5.1内连接
内连接实际上就是利用where子句对两种表形成的笛卡儿积进行筛选。
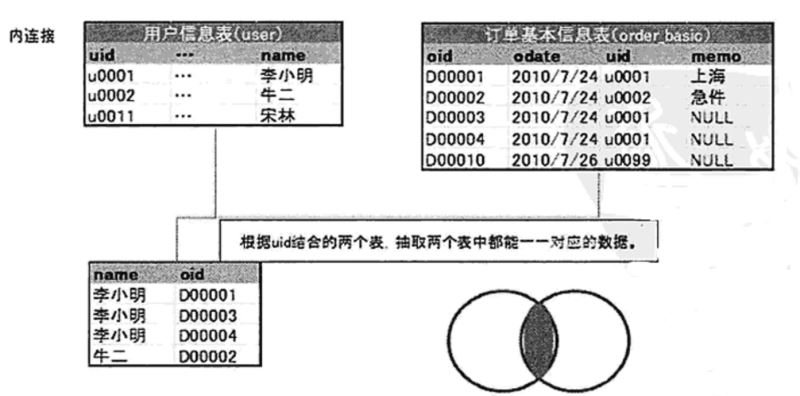
语法:
select 字段 from 表1 inner join 表2 on 连接条件 and 其他条件;
示例:
--用前面的写法
select ename,dname from EMP, DEPT where EMp.deptno=DEPT.deptno andename='SMITH'
--用标准的内连接写法
select ename, dname from EMp inner join DEPT on EMP.deptno=DEPT.deptno andename='SMITH':
5.2 外连接
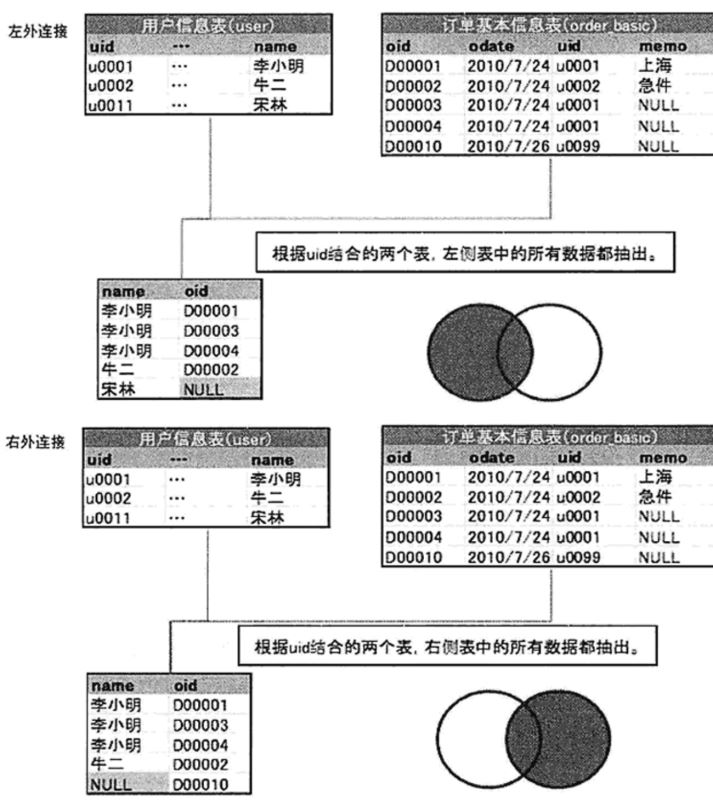
保留左侧表或者右侧表数据
多表内连接耶可以
到此这篇关于mysql表操作与查询的文章就介绍到这了,更多相关mysql表操作与查询内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!